pstack the right way
pstack คือคู่มือที่ทำให้ Coding agent ทำงานเป็นขั้นเป็นตอน หัวใจของมันคือ Verification skill ที่ทำให้ agent ตรวจงานตัวเองได้ด้วยหลักฐานจริง ก่อนจะเริ่มใช้ /poteto-mode
blog นี้เขียนโดยมนุษย์ 100% ครับ ผมเขียนเอง
TL;DR
pstack เป็นเหมือนคู่มือให้ Coding agent มันทำงานเป็นขั้นเป็นตอนนะครับ เมื่องานเสร็จก็ต้องพิสูจน์ด้วยว่างานนั้นเสร็จจริงๆด้วยหลักฐานจริงๆ ฉนั้น Coding agent มันจะต้องไปทดลองใช้งาน app จริงๆเหมือนที่ user เข้ามาใช้งาน app ครับ หัวใจของมันคือตรงจุดนี้แหละครับ project ที่พร้อมให้ Coding agent ตรวจงานตัวเอง
จากที่ผมจั่วหัวไปวันก่อนว่าเริ่มที่ /poteto-mode นั้นมันผิด
สิ่งที่ถูกต้องคือแบบนี้ครับ
เราต้อง setup pstack ให้ถูกต้องก่อนครับ
- อย่างแรกคือ setup role model ก่อนครับ ใน pstack มีบทบาทหลายแบบ เพื่อใช้ในงานต่างๆ
- อย่างที่ 2 คือการใช้ skill
/create-verification-skillครับ skill นี้จะช่วยเราสร้าง Verification skill เฉพาะ project ของเรา เพื่อให้ Coding agent เรียกใช้ Verificiation skill เพื่อตรวจงานตัวเองครับ - อย่างสุดท้ายคือเราต้อง maintain Verification skill ด้วยครับ เมื่อ project เราโตขึ้น Verification skill ก็จะเก่า ให้เราใช้ skill
/maintain-verification-skillเพื่อปรับปรุงมันครับ
ทำไมผมถึงเขียนเรื่องนี้น่ะหรอ
ผมดู youtube เยอะช่วงนี้ ทั้งเมืองนอกและในไทย เกี่ยวกับ pstack
ช่วงนี้ฮิตมากเลยเนอะ สร้างโดยคุณ Lauren Tan (เขาอยากให้เรียกเขาว่า Poteto) เป็น Engineer ที่ Cursor ครับ เธอเป็นคนสิงคโปร์นะ
ครั้งแรกที่ผมเห็นคนพูดถึง pstack ผมรู้ได้ทันทีว่าสวยมาก เอ้ย น่ารักมาก เอ้ย งานดีมาก เอ้ย skillset ชุดนี้มันต้องดีมากๆ เอ่อนั่นแหละ เพราะใครๆก็พูดถึงไง
แต่หลายที่ หลายช่อง ผมว่ายังให้ข้อมูลไม่ครบ และขาดส่วนที่สำคัญที่สุดไป ส่วนนั้นคือ Verification skill ครับ pstack จะทำงานได้ดีก็ต่อเมื่อ repo ของเราพร้อมให้ agent ตรวจงานตัวเองได้ เดี๋ยวผมเล่าละเอียดในหัวข้อ Setup
มีคนถามผมหลายคนว่าลองใช้ pstack หรือยัง ผมยอมรับตามตรงว่ายังศึกษาอยู่ และก็ถามกลับไปว่า “ลองแล้วดีไหม ดีเพราะอะไร”
ผมคิดว่าเราใช้ workflow ของใครก็ได้ทั้งนั้น แต่เรารู้หรือเปล่าว่ามันทำงานอย่างไร แต่ละขั้นตอนเราคาดหวังจะเห็นอะไร หรือบางคนลองแล้วก็เอ๊ะ ไม่เห็นต่างจาก workflow อื่นนี่นา
อ่อ ไม่ต้องรู้หรอก /poteto-mode เขาจัดการให้เองแหละ
แล้วเราจะมั่นใจได้อย่างไรว่า /poteto-mode มันจะทำงานได้ดีกับงานที่เราทำอยู่หรือเปล่า project เราพร้อมสำหรับ pstack หรือเปล่า เคยถามตัวเองไหม
คุณ Lauren Tan เขาสร้าง pstack มาทำงานของเขา เขาไม่เคยมาทำงานเดียวกับเรา
ผมว่าทางออกของเรื่องนี้คือเราก็ต้องไปดู core idea ของ pstack ว่า ที่มาที่ไปเป็นอย่างไร ทำไมถึงสร้าง pstack ขึ้นมา เราจะได้รู้ว่าส่วนไหนบ้างที่นำมาปรับใช้กับงานของเราได้ ถ้ามันตรงกับแนวทาง project ของเราก็จัดไป หรือเราชอบแนวทางของคุณ Lauren Tan ก็ค่อยปรับให้ project เราทำตาม workflow ของเขาครับ
ไม่อยากให้หลับหูหลับตาใช้เพียงเพราะเขากำลังฮิตกันอยู่ครับ
ผมบอกก่อนเลยว่ามันต้องใช้ไปสักพักนึง แล้วต้องปรับจูนไปเรื่อยๆด้วยนะ ทดลองครั้งสองครั้งไม่ได้ทำให้ pstack โดดเด่น ช่วยงานเราได้อย่างที่คุณ Lauren Tan ทำได้ครับ
ตรงนี้หลายคนอาจจะตั้งคำถามกับผมว่าแล้วผมรู้ได้ยังไง มั่วขึ้นมาเองรึเปล่า ทุกคนมีสิทธิ์ตั้งคำถามครับ ถ้าใครตั้งคำถามนี้ในใจขณะอ่าน ผมดีใจมาก เป็นสิ่งที่เราทุกวันนี้ควรทำเยอะๆครับ อย่าเชื่อผม อย่าเชื่อ AI ให้ตั้งคำถามครับ
ผมไม่ได้มั่วขึ้นมาเองครับ ผมไปอ่าน blog ของคุณ Lauren Tan ✎ ลิงก์ blog ต้นทาง แล้วเอามาเล่าต่อในภาษาของผม ทุกจุดที่อ้างตัวเลขหรือคำพูดของเธอ ผมใส่ลิงก์ไว้ให้ตรวจได้ครับ part1 และ part2
blog นี้จะเป็นการสรุปนะครับว่า pstack ทำอะไรได้บ้าง ยาวแน่นอน รวมถึง guide ในจุดที่สำคัญครับ
pstack แก้ปัญหาอะไร
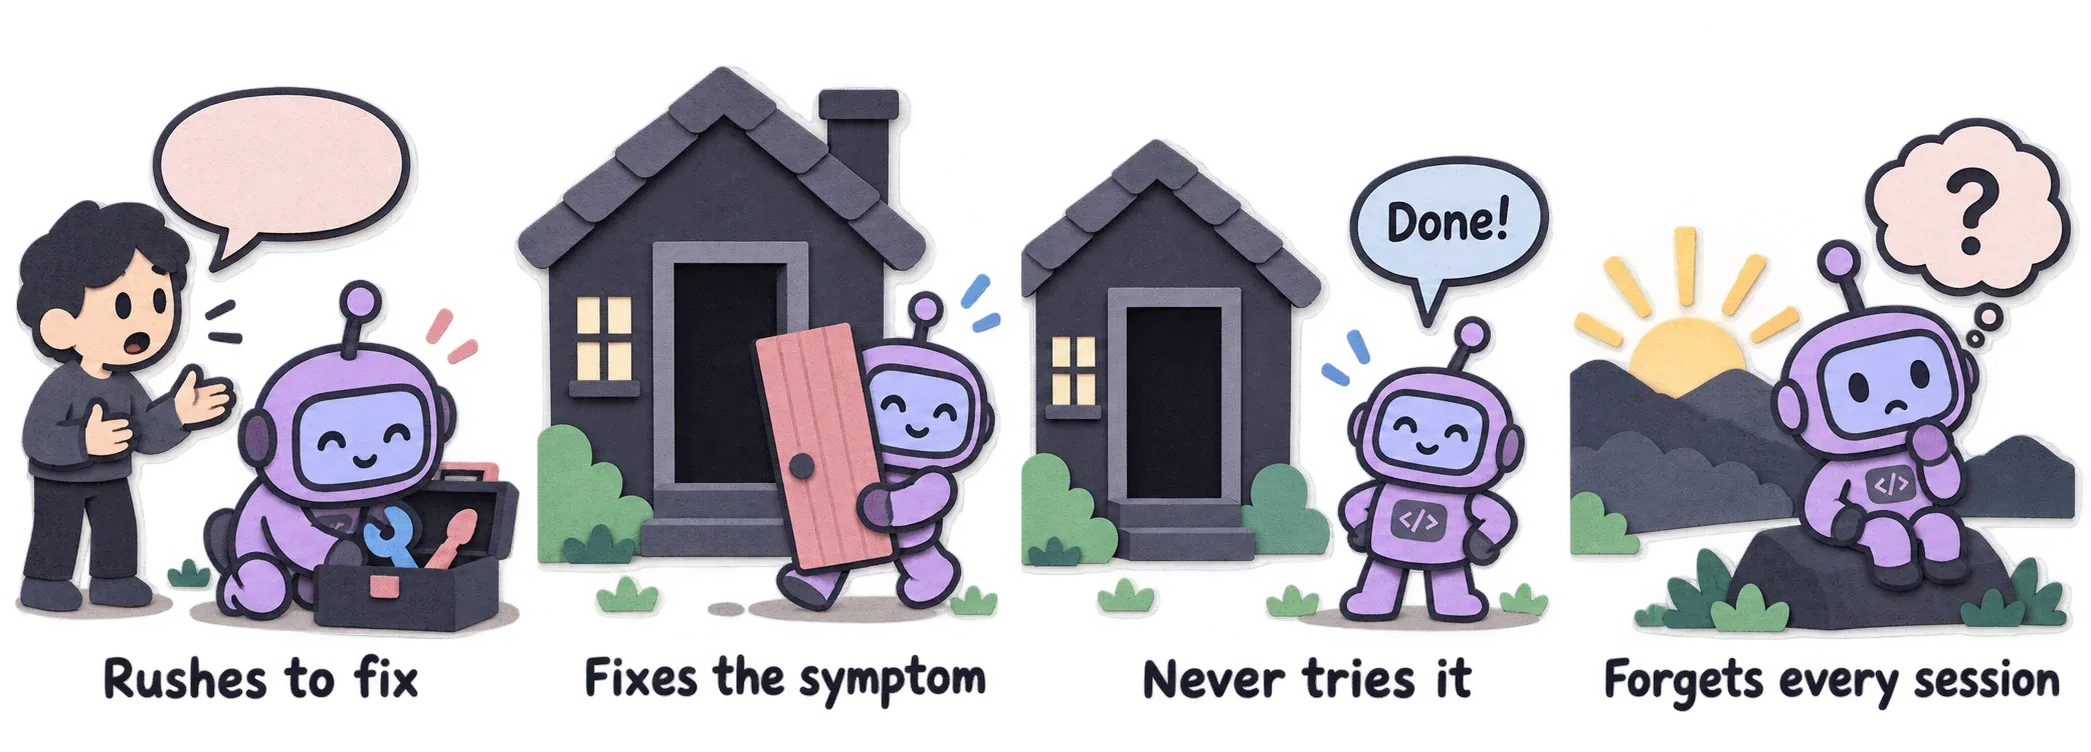
ปัญหาที่ pstack จะช่วยแก้อาการของเจ้าเพื่อน AI ที่มันมีนิสัย 4 อย่างนี้ครับ สมมติว่าเรามีเพื่อนคนนึงเป็นแบบนี้
- พอเราบอกว่ามี bug เพื่อน AI ของเรามันก็จะรีบไปแก้ไฟล์ที่เกี่ยวข้องเลย เหมือนช่างที่ยังไม่ทันฟังอาการก็เปิดกล่องเครื่องมือแล้ว มันรีบอยากทำให้เราพอใจ นี่เป็นธรรมชาติของมันในทุกวันนี้นะครับ
- AI มันจะแก้แค่อาการครับ ประมาณว่าเห็นเราเข้าออกบ้านไม่สะดวกเพราะประตูเสีย ก็ถอดประตูออกแม่มซะเลย เข้าออกบ้านสะดวกละ เราไม่ได้อยากได้งานแบบนี้ เราก็ต้องสั่งสอนใช่มะ
- AI มันไม่ลองใช้งานจริง คือมันถอดประตูออกไปแล้ว แล้วมาบอกเราว่าเสร็จงานแล้ว ทั้งๆที่มันเองก็ยังไม่เคยทดลองเดินผ่านนะ เราก็ต้องสั่งสอนอีกแล้วใช่มะ
- AI เพื่อนเราคนนี้จะลืมทุกอย่างในเช้าวันใหม่ แค่เราขึ้น Session ใหม่ (/new, /clear) มันก็ลืมสิ่งที่เราเคยสั่งสอนไปหมดแล้ว
คุณ Lauren Tan ก็เลยสร้างคู่มือให้กับเพื่อน AI ของเราครับ ตั้งชื่อคู่มือว่า pstack ลืมหรอ ไปอ่านคู่มือซะ
เพื่อน AI ก่อนเริ่มงานในทุกเช้าเราก็ยื่นคู่มือให้มันทุกเช้าไปเลย
ทุกครั้งที่ขึ้น session ใหม่ก็ใช้ /poteto-mode นั่นเอง
ในคู่มือเขียนประมาณว่า
งานแบบนี้ให้ทำขั้นตอนนี้ งานแบบนั้นก็ให้ทำอีกขั้นตอนนึง เสร็จแล้วเอาหลักฐานมาโชว์หน่อย งานเสร็จแล้ว
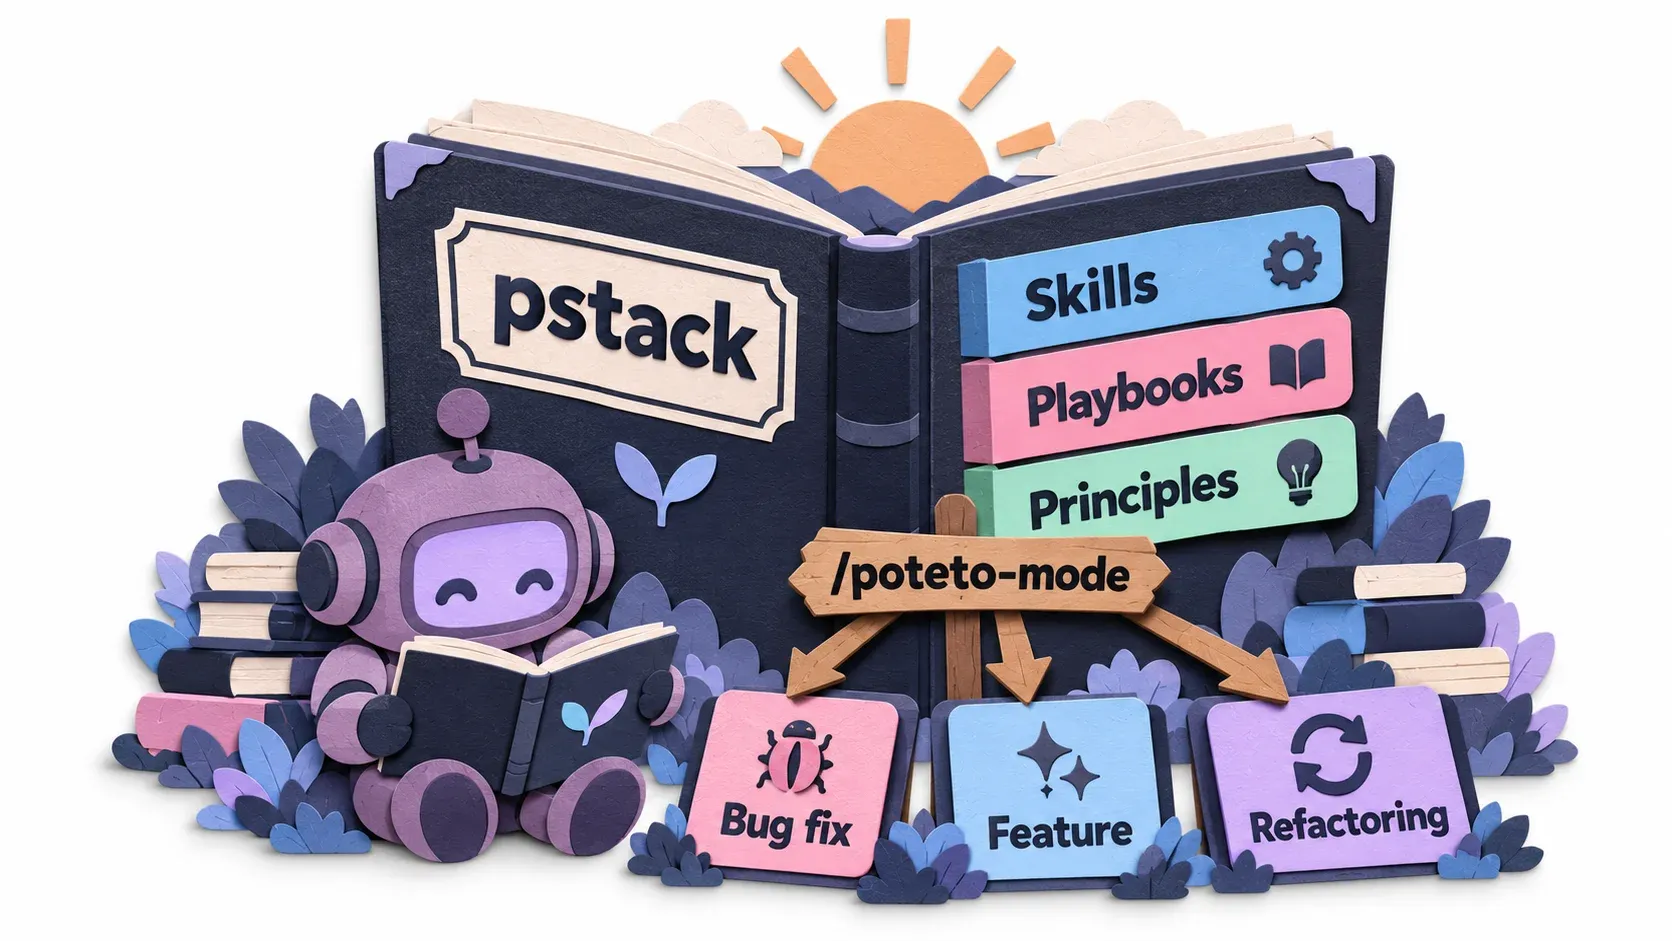
ในคู่มือ pstack มีของ 3 อย่างนี้ครับ
- skills มีเยอะมากๆ ส่วนใหญ่จะถูกเรียกใช้ผ่าน Playbook อีกทีนึง แต่ก็มีบาง skill ที่เราต้องเรียกใช้เองด้วยนะ
- playbook บอกขั้นตอนไว้ล่วงหน้าแบบ step by step เลย ว่างานแบบไหนต้องทำอะไรบ้าง เช่น playbook แก้ bug หรือ playbook ทำ feature มีขั้นตอน 1, 2, 3, 4 ชัดเจน แต่ละ playbook จะเอา skills ในส่วนแรกมาประกอบกันเป็น workflow ที่ทำงานนั้นๆครับ
- Principles เป็นกฎสั้นๆ 24 ข้อ ที่เอาไว้ใช้ใน project ที่ใช้ pstack, principles ก็เป็น skill นะแค่เราไม่ต้องเรียกใช้เองเลย แค่ควรรู้ไว้ว่ามีอะไรบ้าง
จะเห็นว่ามี skills เยอะ ไหนจะ playbooks อีก
มีหลายตัวเลย จำไม่ได้หรอก
ตรงนี้คุณ Lauren Tan เองก็เจอปัญหา ฮ่าๆ
เขาเลยทำ skill อันนึงที่เอาไว้ทำ routing ประมาณว่า เรามีงานที่อยากทำอยู่แต่ไม่รู้ว่าจะใช้ playbook ไหนดี ก็ถาม skill นี้แหละ
skill นี้เรียกว่า /poteto-mode นั่นเอง เป็นจุดที่ทำให้เราเริ่มใช้งาน pstack ได้ง่ายๆเลย
Core idea ของ pstack คือ การทำให้ Coding agent ของเราสามารถตรวจงานตัวเองได้ครับ พอเป็นแบบนั้นแล้ว Coding agent มันก็จะทำงานต่อจนเสร็จงานจริงๆได้โดยที่ไม่ต้องรอเรา ถ้า Coding agent ตรวจงานเองไม่ได้ ก็เท่ากับว่าต้องรอเราให้มาตรวจใช่มะ เราก็จะเป็นคอขวดน่ะสิ งาน Line Developer 2026 อ.ต้า วิโรจน์ บอกว่ามนุษย์นี่แหละเป็นจุดที่ช้าที่สุดใน SDLC แล้วในตอนนี้ ช่วยเสริมน้ำหนักกันไปอีก ถ้า Coding agent ไม่ต้องรอเราได้ มันก็ดีใช่มะ ก็เราไม่ว่างจะมาตอบ ผมเองก็จะไปซ้อมวิ่ง น้องๆอาจจะดู Netflix กันอยู่
ผลที่ได้คือคุณ Lauren Tan ส่ง PR ได้มากกว่า 2,000 อันในหนึ่งเดือน (แล้วคอขวดก็ย้ายไปอยู่ที่คนรีวิวแทน ตรงนี้ผมเติมเอง ซึ่งถ้าเห็นด้วยตรงนี้ไม่ใช่ความผิดของคุณ Lauren Tan ครับ เพราะงานของเขาก็ออกมาสมบูรณ์ดี และเขาสวย น่ารัก จะมีความผิดได้ไง)
ฉะนั้นที่หลายคนเปิด project แล้วใช้ /poteto-mode เลย ผมว่าเริ่มผิดลำดับครับ
เราถามตัวเองหรือยังว่า project ของเราพร้อมให้ Coding agent ตรวจงานตัวเองได้หรือยัง ถ้ายัง /poteto-mode ก็จะทำได้แค่บอกว่าเสร็จ โดยพิสูจน์ไม่ได้ ลำดับที่ถูกคือสร้าง Verification skill ก่อน แล้วค่อยใช้ /poteto-mode
คุณ Lauren Tan บอกว่า “Verification is all you need” ล้อมาจาก “Attention is all you need” มั้งนะ ผมก็เดาไปเรื่อย
ภาพรวม: งาน 1 ชิ้นเดินทางอย่างไร
มาดูภาพกว้างๆกันก่อนว่าถ้าเรามีงาน 1 ชิ้นที่ Coding agent จะต้องทำ โดยใช้ pstack มันจะเดินทางยังไงบ้าง
มี 5 ขั้นครับ
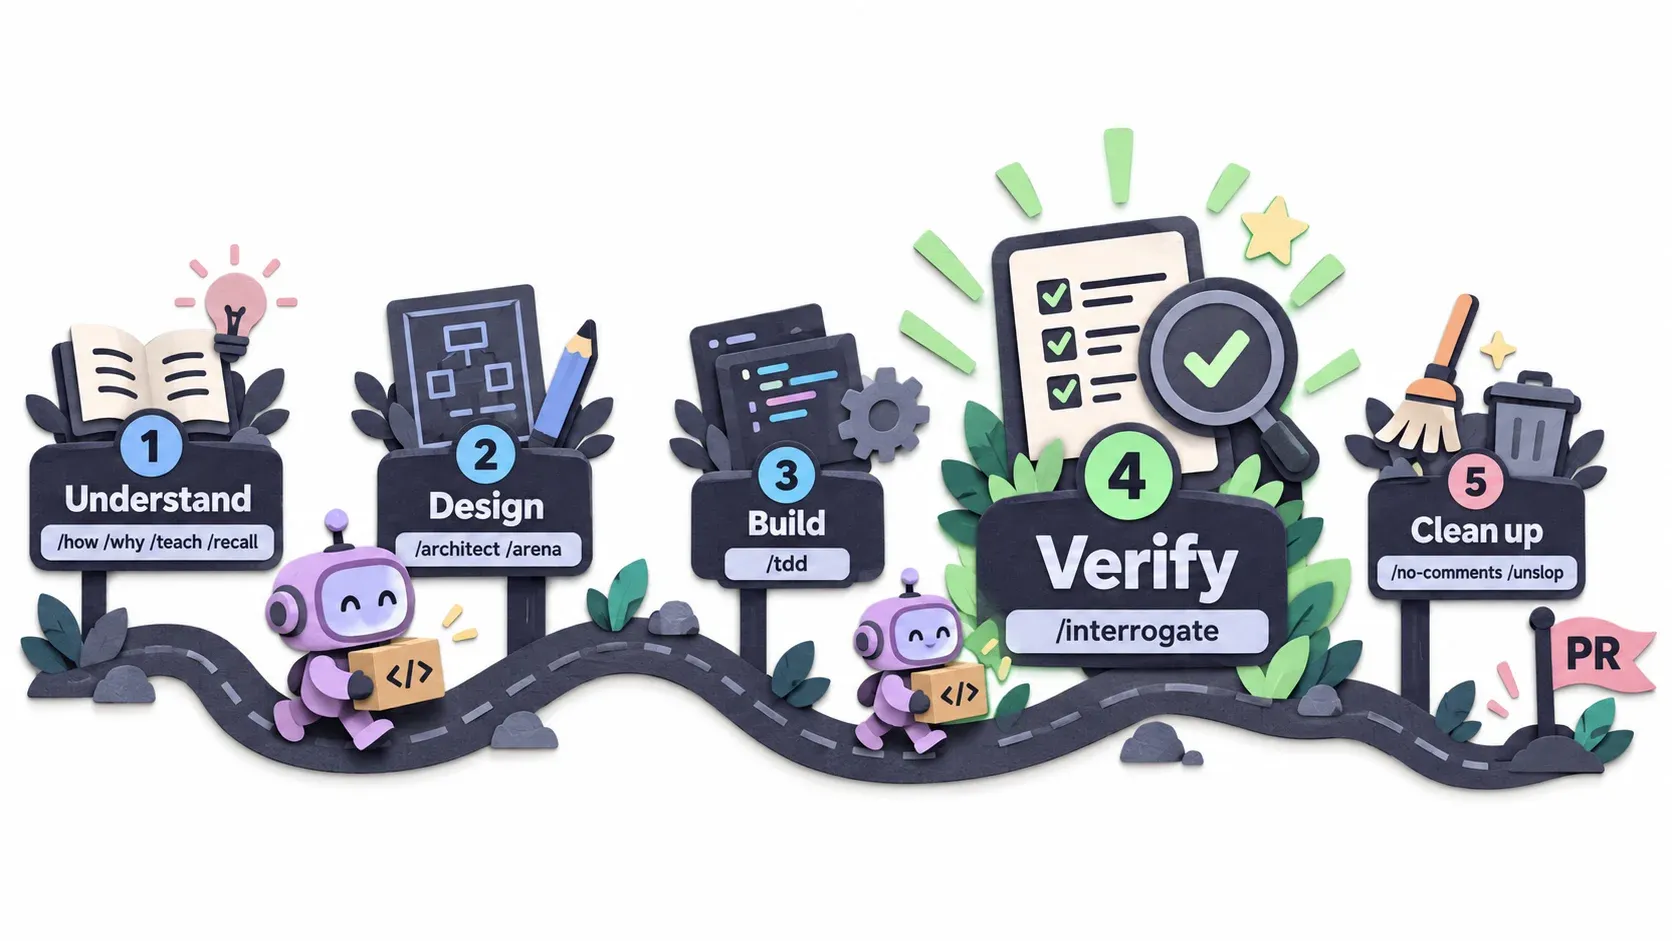
- ทำความเข้าใจ code ของเราก่อน มันอาจจะใช้ skill
/how,/why,/teach,/recall - ออกแบบ โดยใช้skill
/architect,/arena - ลงมือทำงาน โดยใช้skill
/tdd - verify นี่คือจุดที่สำคัญที่สุด คือจุดเด่นของ pstack ตาม core idea ของเขาเลยครับ skill
/interrogateแล้วเก็บเหตุการณ์ต่างๆที่เจอตอน review ไว้ใน log - clean up เช่นลบ comments จัดการเอกสารที่เกี่ยวข้องเพื่อให้คนอ่านง่ายขึ้น ใช้ skill
/no-comments,/unslopแล้วปิดด้วย playbook Opening a PR (เรื่อง comment ดูรายละเอียดในหัวข้อ/no-comments)
5 ขั้นด้านบนเป็นแค่ภาพคร่าวๆ ย้ำอีกครั้งว่าจุดที่สำคัญที่สุดคือขั้นที่ 4 Verify
ศัพท์ที่ต้องรู้ก่อนอ่านต่อ
เวลาเราใช้งาน pstack มันจะมีคำศัพท์แปลกๆอยู่ด้วย ขอเก็บเฉพาะคำที่ต้องใช้ตั้งแต่ตอนนี้ คำที่เหลือผมอธิบายตอนเจอครั้งแรก
อันนี้ผมตั้งใจใส่มาด้วยครับ ตอนผมอ่าน pstack ใน repo เขาผมมึนมากๆครับ สำหรับผมศัพท์ยากมากครับ ต้องพึ่ง AI ให้แปลอยู่หลายรอบ เอาจริงๆตอนที่ผมเขียนเนี่ยก็ลืมบางคำไปแล้ว ฮ่าๆ
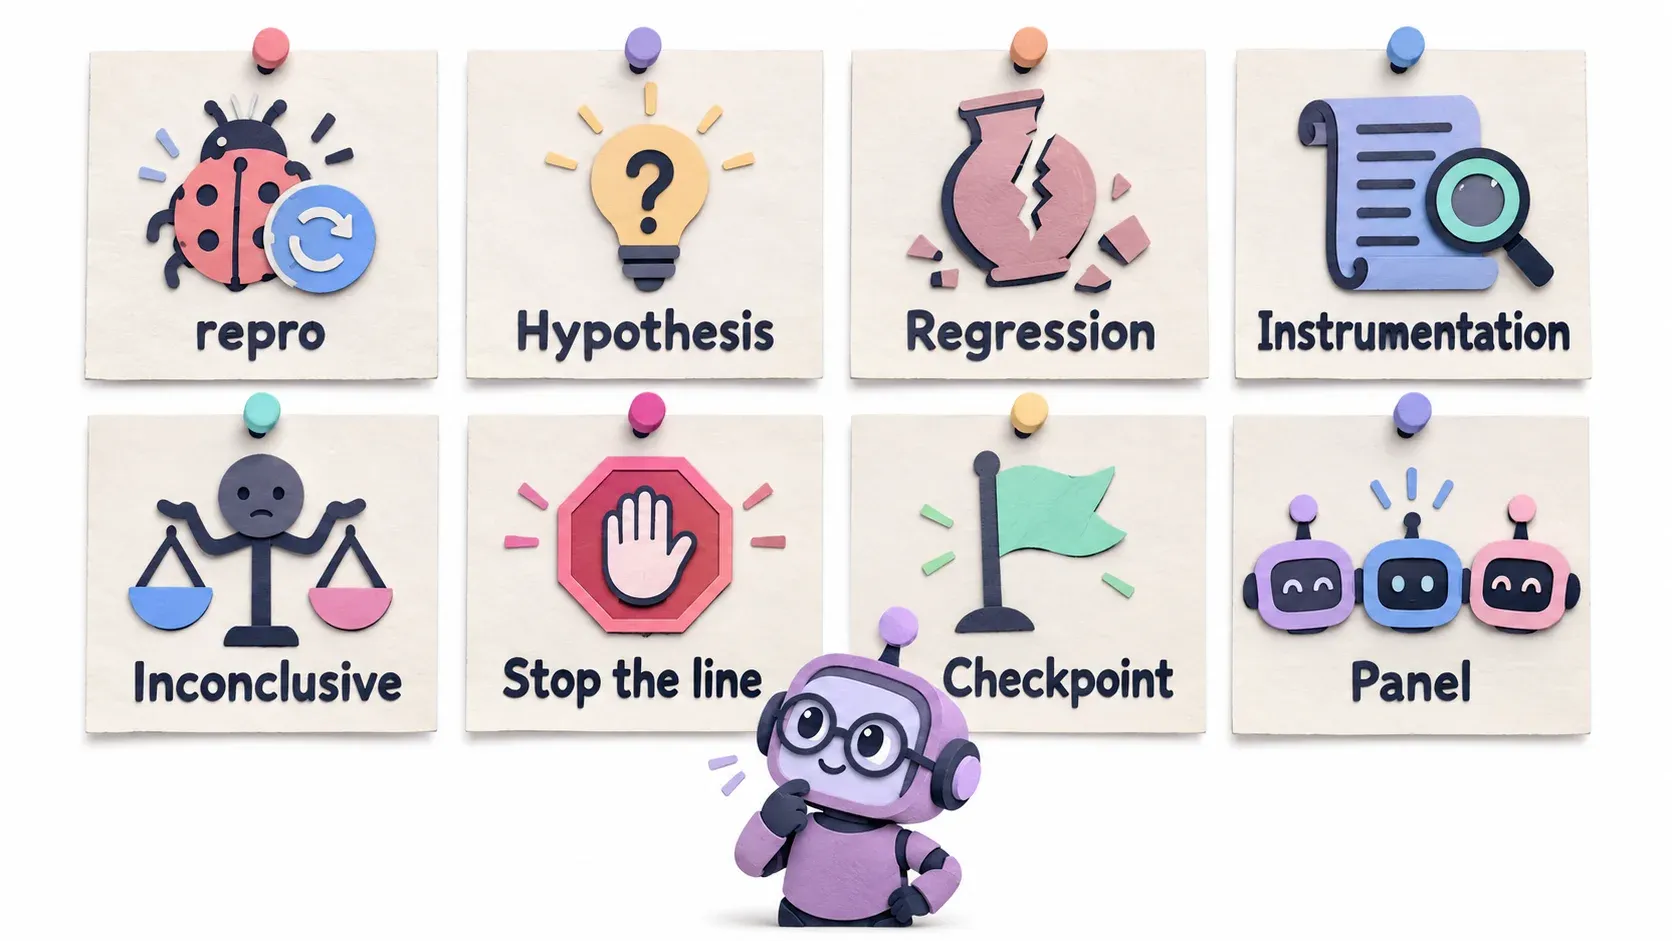
- repro = มาจาก reproduce ครับ พอคนรายงานว่ามี bug เราก็ต้องมาไล่หาว่า bug มันเกิดได้ยังไง นี่แหละ reproduce ย่อเหลือ repro
- Hypothesis (สมมติฐาน) = สิ่งที่เราสงสัย เวลามี bug เราอาจคิดไปล่วงหน้าว่าน่าจะเป็นตรงนั้นตรงนี้ แต่ต้องไปพิสูจน์ก่อนว่าจริงหรือเปล่า
- Regression = เราเคยมีของที่ทำงานได้ปกติ แล้วแก้ code แล้วของนั้นดันพัง
- Instrumentation = ในบริบทของ pstack คือการใส่ log ชั่วคราวเพื่อดูค่าต่างๆ
- Inconclusive = หลังจากทำงานแล้ว Agent สรุปไม่ได้ว่างานเสร็จไหม เพราะตรวจผลไม่ได้ หรือผลลัพธ์ไม่ชัด เช่นทำเว็บเสร็จแต่ไม่มี browser ให้ตรวจ
- Feature map = แผนผังว่าระบบเรามี features อะไรบ้าง เก็บเป็น markdown files
- Stop the line = หยุดงานเลย ถ้าในขั้นตอนนั้นทำต่อไม่ได้ เช่น reproduce bug ไม่ได้ ก็ไม่ต้องกระเหี้ยนกระหือรือไปแก้ bug ให้หยุดเลย
- checkpoint = จุดที่ agent หยุดรอคำตอบจากเรา เช่นอยากให้ทำ prototype ให้เราเลือกก่อนตัดสินใจทำต่อ
- Panel = งานเดียว แต่ให้ model หลายตัวหลายค่ายมาทำแข่งกัน แล้วค่อยเลือกผลที่ดี
- Verification skill = ชุดเครื่องมือของ repo เราเอง ที่ให้ Coding agent ใช้ app ได้เหมือน user แล้วเก็บหลักฐานกลับมา ข้างในมี SKILL.md, CLI และ feature map รายละเอียดจะอยู่ด้านล่างนะ
ไป ลุยกันต่อ อ่านไม่จบไม่ต้องพัก
Setup
pstack ตัวดั้งเดิมออกแบบมาให้ใช้กับ Cursor เพราะคุณ Lauren Tan ทำงานที่ Cursor ถ้าใช้ Cursor สั่ง /add-plugin pstack ได้เลย
ถ้าใช้ Claude Code / Codex / Pi / OpenCode ก็มีคน port มาให้แล้ว เช่น michael-denyer/pstack-claude
ส่วนผมใช้ omp ครับ ผม port pstack เป็น omp plugin เอง ตอนนี้ทำเสร็จแล้ว ยังขอลองใช้ดูก่อนจะเปิด public ครับ
บอกไว้ก่อน ผมไม่ได้ใช้ Cursor และไม่ได้ลอง pstack-claude ส่วนที่พูดถึงสองตัวนั้นผมอ่านจากเอกสารมา และ blog นี้ไม่ได้มาสอน setup ทีละขั้น ผมอยากเล่า core concept ที่ใช้ได้กับทุก harness น่ะครับ
สิ่งที่ต้อง setup มีแค่ 2 อย่าง
- setup project ของเราให้ Coding agent ตรวจงานตัวเองได้ (สำคัญที่สุด ทำก่อน)
- model roles เพราะ pstack มักใช้หลายๆ model ทำงานเดียวกัน (ตั้งทีหลังได้ ไม่ตั้งก็ใช้ได้)
1. setup verification กัน
ส่วนนี้สำคัญที่สุดของบทความ ถ้าเวลาน้อยขอให้อ่านตรงนีัให้จบนะครับ ขอร้อง
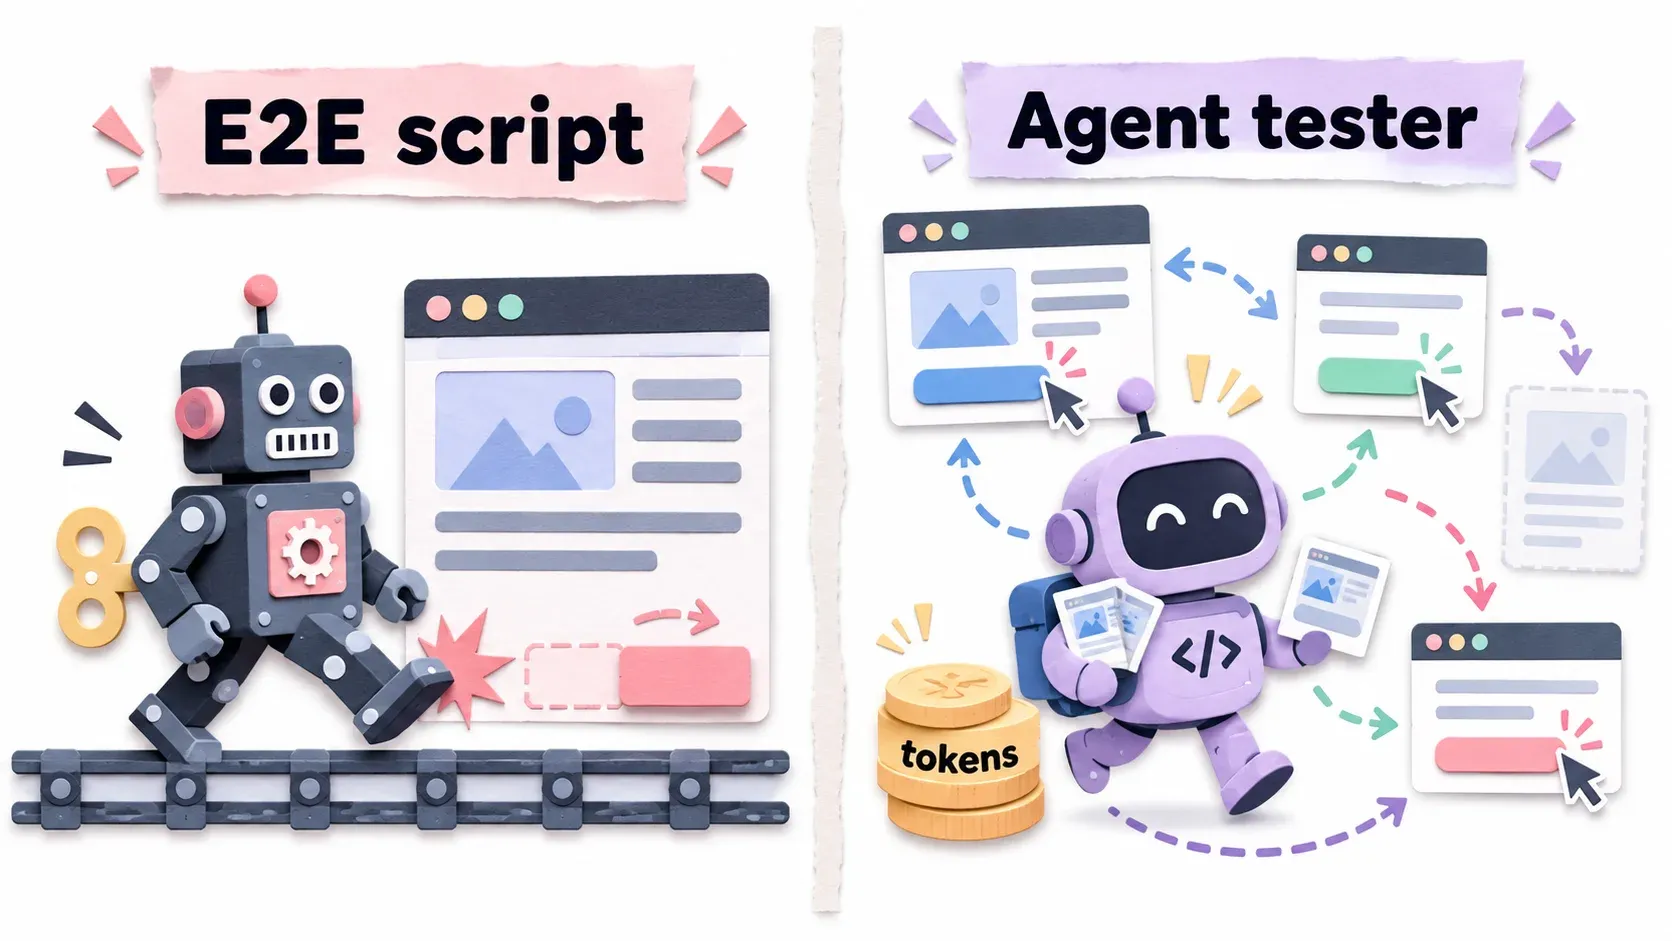
ถ้าให้เทียบกับของที่คุ้นเคย มันคล้ายการทำ E2E testing ครับ ต่างกันตรงที่ E2E เป็นสคริปต์ตายตัว ส่วนนี่ Coding agent เป็นคน test ครับ มันปรับตัวได้ตามงานมากกว่า แต่ก็ต้องจ่าย token อะนะ
ในขั้นตอน setup pstack มันจะถามว่าเราอยาก create verification skill ไหม ตรงนี้เป็นสิ่งที่ต้องทำ ไม่ใช่สิ่งที่เลือกได้ครับ คุณ Lauren Tan เรียกสิ่งนี้ว่า critical infrastructure และบอกว่าถ้าทำออกมาดี จะเพิ่มผลงานทั้งทีมได้ 100–1000 เท่าเลยนะเออ
ใน pstack จะมี skills 2 ตัวที่เกี่ยวข้องกัน
- create-verification-skill
- maintain-verification-skill
verification skill คืออะไร
ผมอยากพาย้อนกลับไปที่ปัญหาก่อน เพื่อนน่าจะเคยเจอปัญหาว่า ตอนที่ Coding agent บอกว่าแก้ bug แล้ว test ผ่านหมด แต่พอเปิด app ของจริง อ้าวแตก app ยังพังอยู่เลย แล้วเราเจอตอนไหน ก็หลังจากที่ได้รับรายงานว่าเขียน code เสร็จแล้วไง
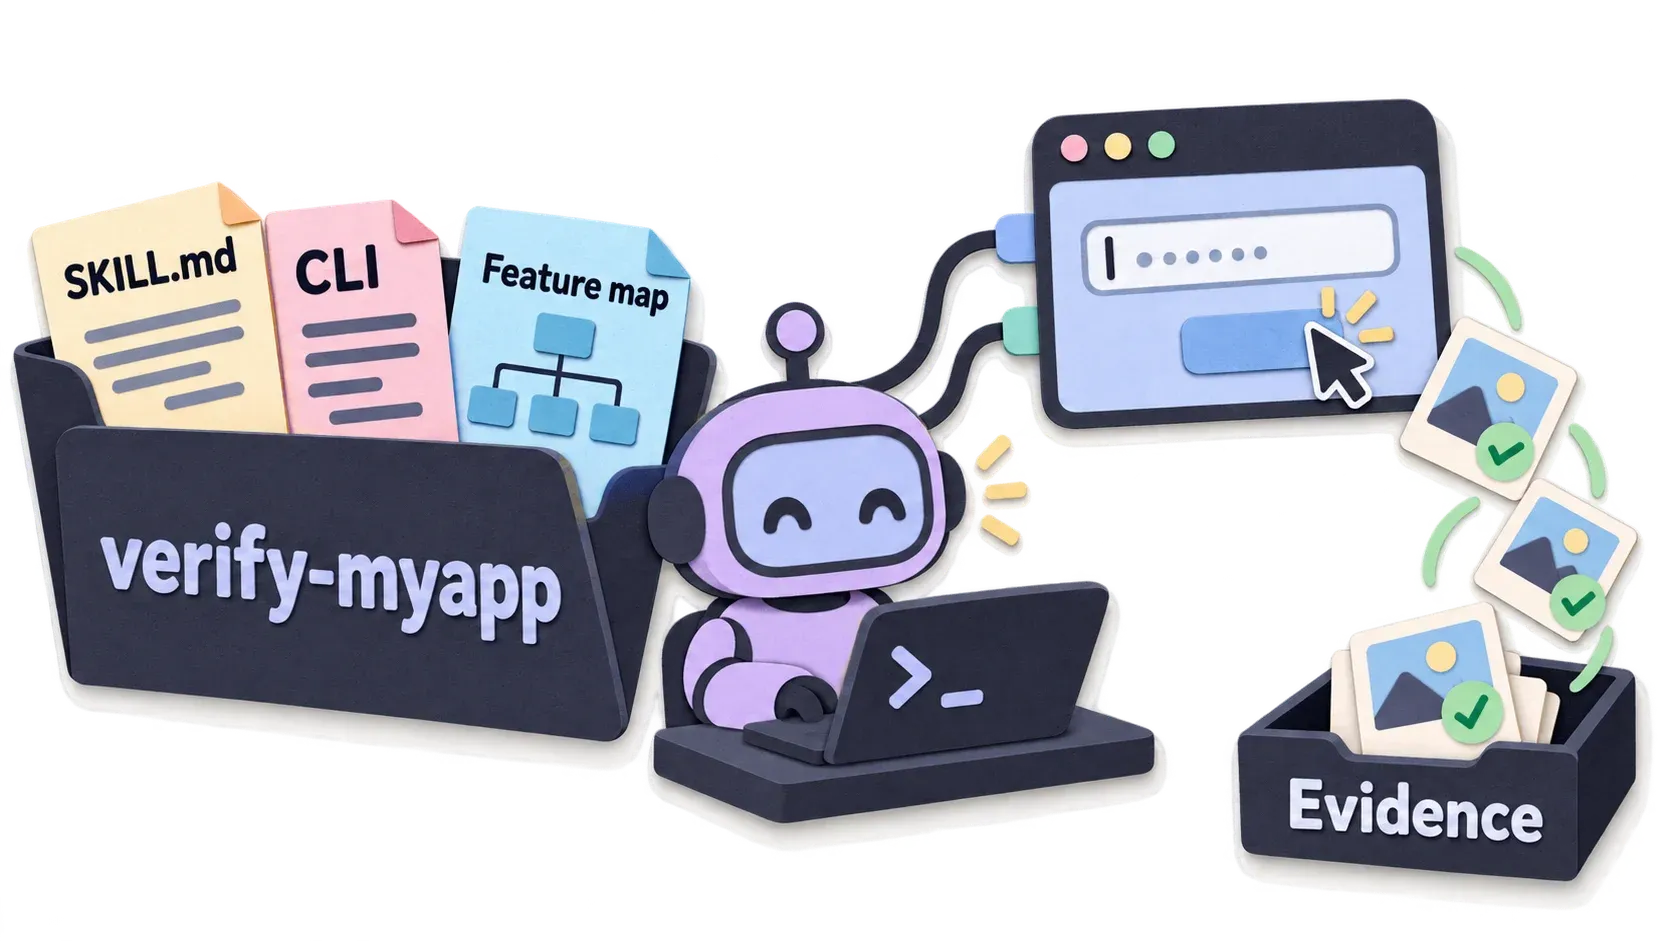
สิ่งที่ pstack ทำก็คือสร้างเครื่องมือให้ Coding agent เปิดใช้งาน app ได้จริงๆ เหมือนที่ users เล่นที่หน้า app เลย แล้วใช้เครื่องมือเหล่านี้เล่น app ไปทุกๆจุด จนมั่นใจว่ามันทำงานได้จริง แล้ว snapshot ภาพเก็บไว้เป็นหลักฐานด้วย
หลังจาก Coding agent เขียน code เสร็จมันจะต้องเรียกใช้เครื่องมือเหล่านี้แหละ เพื่อพิสูจน์งานของตัวเองพร้อมหลักฐานครับ
เครื่องมือเหล่านี้แหละที่ทำให้ Coding agent ตรวจงานของตัวเองได้ ไม่ต้องมารอเราตรวจ เราก็จะได้ไม่ต้องเป็นคอขวดครับ
นี่คือ Core concept นี่คือหัวใจ ของ pstack ครับ คือการที่ทำให้ Coding agent มันตรวจงานตัวเองได้ครับ
และ skill /create-verification-skill มันจะช่วยเราสร้างสิ่งนั้นครับ
blog ของคุณ Lauren Tan เองก็เริ่มต้นด้วยการพูดถึง Verification skill เป็นสิ่งแรกครับ
แถมๆ ถ้าหากว่า repo ของเรามีเครื่องมือที่ช่วยให้ Coding agent ตรวจสอบงานของตัวเองได้ คนที่ไม่ใช่ developer ก็สามารถใช้ Coding agent ทำงานง่ายๆได้ด้วย โดยไม่ต้องรอ developer มันก็จะดีต่อบริษัทใช่ไหมละ
pstack เรียกชุดเครื่องมือทั้งหมดนี้ว่า Verification skill ครับ หน้าตามันคือ folder หนึ่งอัน ข้างในมี 3 อย่าง
- SKILL.md บอก agent ว่าจะ verify app นี้อย่างไร
- CLI ที่จำลองการเป็น user ของเรา แยก sub-command ตามสิ่งที่ user ทำใน app
- Feature map เป็น markdown บอกว่า app มี feature อะไรบ้าง อยู่ตรงไหน
Verification skill นี้จะถูกเรียกใช้ใน Playbook ต่างๆด้วย
สิ่งที่อยากได้คือทำยังไงก็ได้ให้ Coding agent ของเราใช้งาน app ได้เหมือนกับที่ users ใช้งานครับ เช่นถ้าทำ website ก็ต้องมี browser การที่ agent จะใช้ browser ได้ก็มีหลายแบบ ขึ้นอยู่กับ project setup ของเราด้วยครับ บางคนอาจจะใช้ Chrome DevTools Protocol (CDP) หรือ agent-browser ก็แล้วแต่สะดวกครับ หรืออาจจะใช้ Playwright MCP ก็ได้อยู่ครับ ส่วนตัวผมใช้ CDP เพราะว่า omp มัน built-in มาอยู่แล้วครับ หรือถ้าทำ iOS app ก็อาจจะต้องมี simulator ซึ่งปกติก็มีอยู่แล้วใช่มะ
/create-verification-skill มันจะสร้าง cli ครอบสิ่งเหล่านั้นอีกทีนึงครับ โดยเน้นว่าให้มี sub-commands เยอะๆ แทนการมี single command เพื่อทำงานทุกอย่างครับ เดี๋ยว agent มันจะใช้ flag —help ไต่ commands ไปเรื่อยๆเอง รวมถึงทำให้ cli มัน composable ด้วยครับ หมายถึงใช้ cli กับอีก cli อื่นๆได้ด้วยครับ
ถ้าหากการ test นั้นเสี่ยงที่จะลบ data ใน DB ตัว cli ก็ควรมีโหมด --dry-run ด้วย
ทั้งหมดนี้ skill จะช่วยเราทำครับ
ตัวอย่าง prompt นะ
/create-verification-skillถ้าต้องสร้าง CLI คุมแอป ขอให้มี:- คำสั่งน้อยแต่ทำงานได้จริงและต่อกันได้ ใช้ subcommand แยกหมวด- --dry-run ในคำสั่งที่ลบหรือแก้ข้อมูล- error message บอกว่าควรทำอะไรต่อ- --help ครบ- output เป็น JSONทำไมต้องเป็น cli ก็เพราะว่า Coding agent มันชอบครับ มันเรียกใช้งานได้สะดวกภายในตัวมันเองเลย ไม่ว่า harness เจ้าไหนๆ อย่างน้อยๆก็ต้องใช้ Bash ได้ใช่ไหม ฉะนั้นเราจะได้ cli ที่ทำงานเป็น user แทนเรา เราไม่ต้องมานั่งกดเองแล้ว สั่ง cli ได้เลย
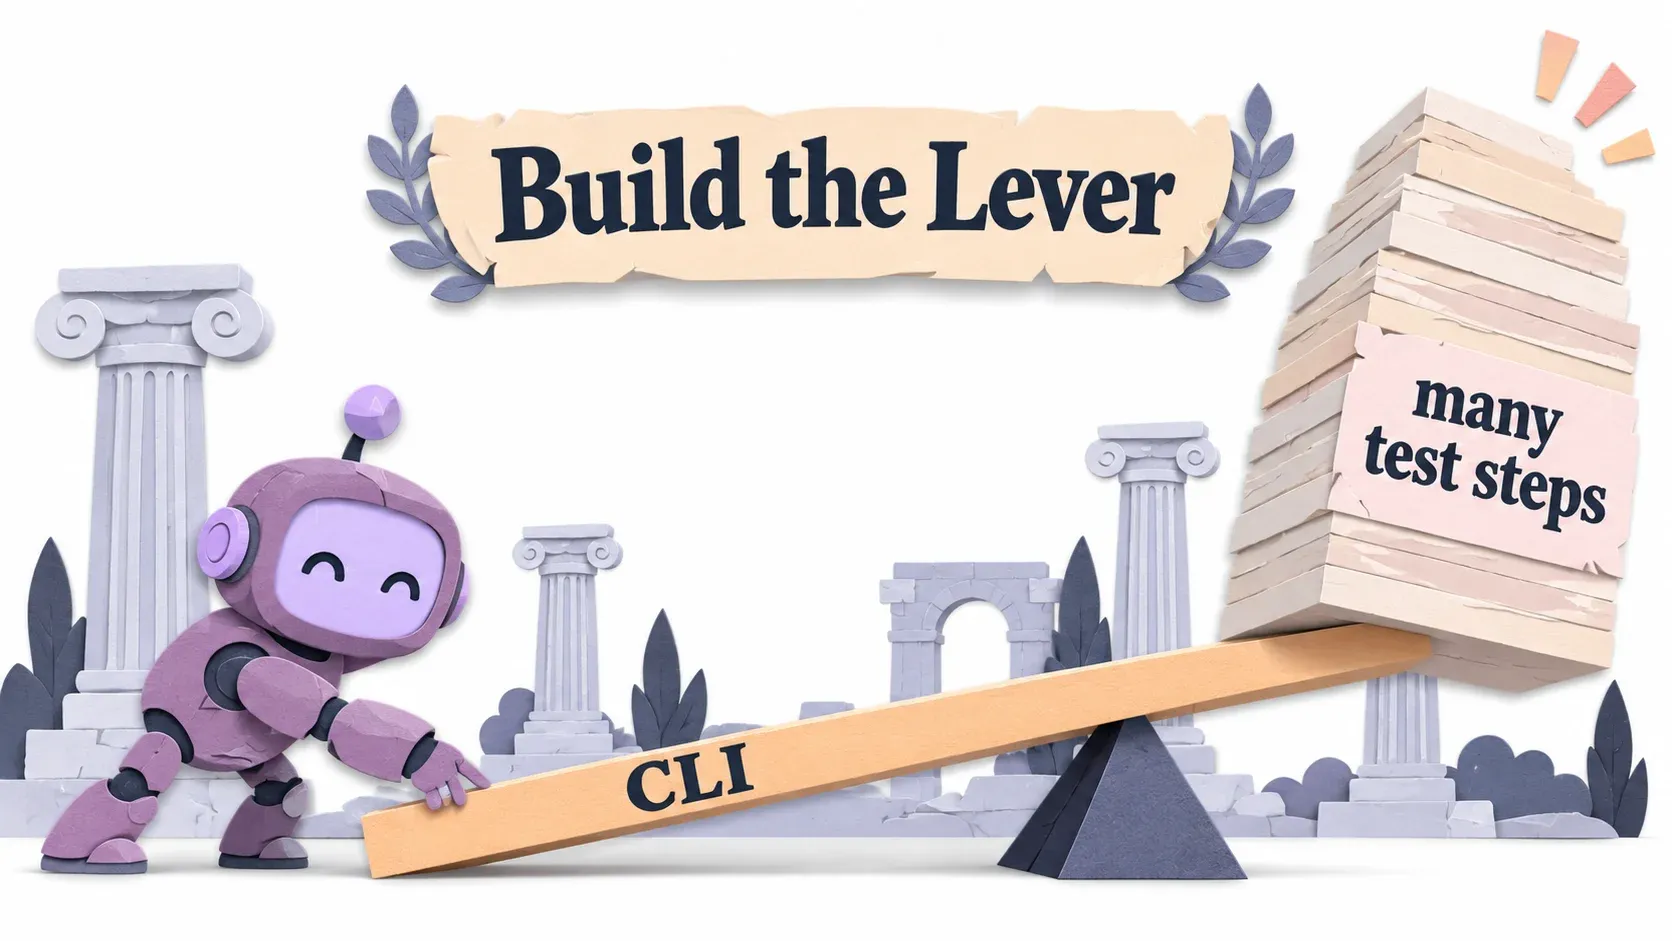
ทำให้ประหยัด token ได้มากๆ และ test ได้เร็วขึ้นด้วย การที่ test ที่เร็วขึ้น ก็มีประโยชน์มากขึ้นด้วยครับ หากว่า cli test แล้วเจอว่า app พัง agent มีแนวโน้มที่จะทดลองรัน cli test นั้นอีกครั้งเพื่อความมั่นใจก่อน แล้วค่อยลงมือแก้ครับ ใน pstack เรียกการสร้าง cli นี้ว่า Build the Lever ครับ
ผมเพิ่งฟังเรื่องนี้จากแอดทอยในงาน Line Developer 2026 มาหมาดๆเลย มันเป็นคำพูดของ “Archimedes” ครับ บอกว่า “Give me a lever long enough and a fulcrum on which to place it, and I shall move the world” “เอาคานงัดและที่ยืนให้ฉัน เดี๋ยวฉันจะย้ายโลกใบนี้เอง”
ยากไปอีก ความหมายประมาณว่า “ขอเพียงมีเครื่องมือและโอกาสที่เหมาะสม ไม่มีสิ่งใดในโลกที่แปรเปลี่ยนไม่ได้”
“Lever” แปลว่าคานงัดในภาษาไทย มันเป็นเครื่องมือที่ช่วยทำให้เราออกแรงน้อยแต่ยกของหนักได้
ใน pstack ก็มองว่า cli เป็น “Lever” ครับ ทำให้การ test ที่ต้องทำหลายๆ steps เยอะๆ บ่อยๆ เป็นงานง่ายๆด้วยคำสั่งแค่ใน cli คำสั่งเดียว อะไรแบบนั้นครับ
แต่ละ project แต่ละ repo ก็ต้องการการวิธีการตรวจสอบใช้ tools ไม่เหมือนกัน เราจึงจำเป็นจะต้องมี tools/cli เฉพาะเจาะจงกับ project เราครับ เป็นที่มาที่ผมตั้งคำถามไว้ตอนแรกว่าเรารู้หรือเปล่าว่า repo ของเราเหมาะกับ pstack หรือเปล่า ตรงนี้คือคำตอบครับ
ย้ำอีกครั้ง เป้าหมายไม่ใช่ Test มากขึ้น แต่คือให้ agent พิสูจน์ด้วยหลักฐานจริงว่าสิ่งที่ agent ทำมาเนี่ยมันใช้งานได้ เหมือนที่คนจะไปตรวจเอง
อีกสิ่งหนึ่งที่ /create-verification-skill สร้างคือ Feature Map ครับ
การที่ Coding agent มันรู้ว่า app ของเรามี features อะไรบ้าง มันก็ต้องไปค้นหาไล่ๆโค้ดไปเรื่อยๆใช่มะ
ใน app ของเราถ้ามี features นิดหน่อยก็อาจจะไม่เป็นไร แต่ถ้ามีเยอะๆ มันก็จะใช้เวลาหานาน
ใช้เวลาหานานก็ไม่เท่าไร แต่ถ้าหากันบ่อยๆมันนี้จะเริ่มเปลือง tokens ละ
pstack ก็เลยเลือกที่จะสร้าง Feature map ครับ เก็บไว้ใน markdown บอกว่า features ไหนอยู่ตรงไหน ใช้ทำอะไร, user เข้าใช้งาน features นี้จากหน้าไหน มี steps อะไรบ้าง
บางคนอาจจะสงสัยว่าแบบนี้มันจะดีหรอ ผมสงสัยเองแหละ ผมใช้ codegraph อยู่แล้ว ผมก็สงสัยว่าการทำแบบนี้มันจะทับซ้อนกับงานของ codegraph หรือเปล่านะ แต่ไม่ครับ Feature map เป็นแค่ภาพ overview ของ project เรานะครับ codegraph ก็มีประโยชน์เหมือนเดิม
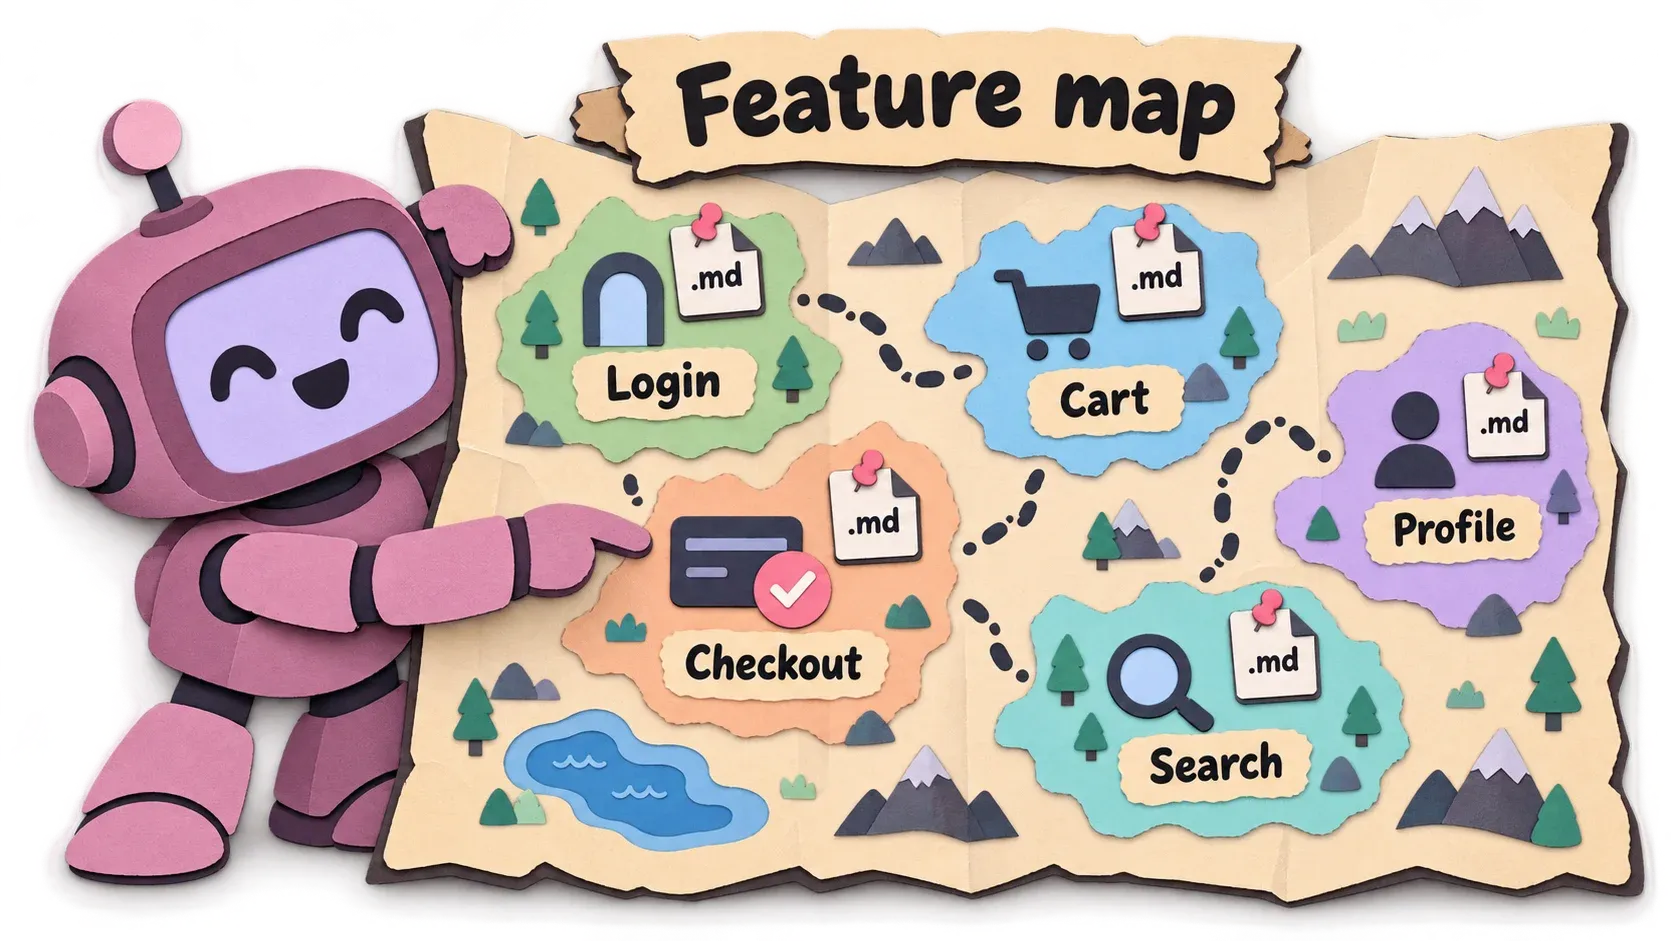
เราจะได้ Markdown files เยอะแยะเลยนะ ถ้าหากว่ามี features เยอะ
ตรงนี้หลายคนอาจจะมีคำถามถึงถ้าเป็น project ที่ขึ้นใหม่เลยละ ยังไม่มีอะไรเลยนะ จะสร้าง Verification skill ได้หรอ
เอ๊ะหรือไม่มีคนสงสัย เอาเป็นว่าผมนี่แหละสงสัย
คำตอบคือ pstack ก็สามารถทำงานใน green field project ได้แหละ แค่ยังไม่ต้องสร้าง Verification skill อะ ก็มันยังไม่มีอะไรเลย ต้องอย่าลืมว่า Verification skill เป็นการสร้าง tools เพื่อเลียนแบบการใช้งานของ User จริงๆ
เมื่อไม่มี app อะไรเลยก็เลยไม่ต้องสร้างก็ได้
ส่วนตัวผมแนะนำว่าถ้าเป็น green field project ให้ใช้ skill ของพี่ Matt ก่อน /grill-with-doc แล้วคุยเรื่อง Verification skill ด้วยเลย ทำ feature เล็กๆก่อน ด้วย flow ของพี่ Matt ไปก่อน แล้วก็ค่อยๆ /create-verification-skill แล้วก็คอย /maintain-verification-skill ต่อไปเรื่อยๆ
ทั้งสองอย่างนี้ (Verification skill กับ Feature Map) มันต้องการการ update ครับ ใน repo ของเรามีการเพิ่ม features, ตัด features, แก้ bugs, แก้ behavior ต่างๆ อยู่ตลอดเวลา
ฉะนั้นตอนที่เราใช้ /create-verification-skill มันก็นานแล้วไง มันก็เก่าไปอะดิ
จึงเป็นที่มาของ skill /maintain-verification-skill ครับ
คุณ Lauren Tan แนะนำว่าควรจะต้องหมั่น update Verification skill กับ Feature map อยู่ตลอดเวลาเช่นกัน
โดยให้ใช้ skill /maintain-verification-skill ทุกวันครับ
และตรงนี้แหละที่ผมบอกว่าใช้แค่ครั้งสองครั้งอาจจะยังไม่เห็นผลมากเท่า เราต้องปรับปรุงปรับจูนกันอยู่ตลอดให้ verification skill มันดีขึ้นอยู่ตลอด เพื่อที่ Coding Agent จะได้ใช้มันตรวจงานตัวเองได้ครับ
ถ้าเราเห็นประโยชน์ของมันจริงๆ ไม่แน่เราอาจจะอยากตั้งเวลาให้มัน update แบบ auto เลยก็ได้นะ
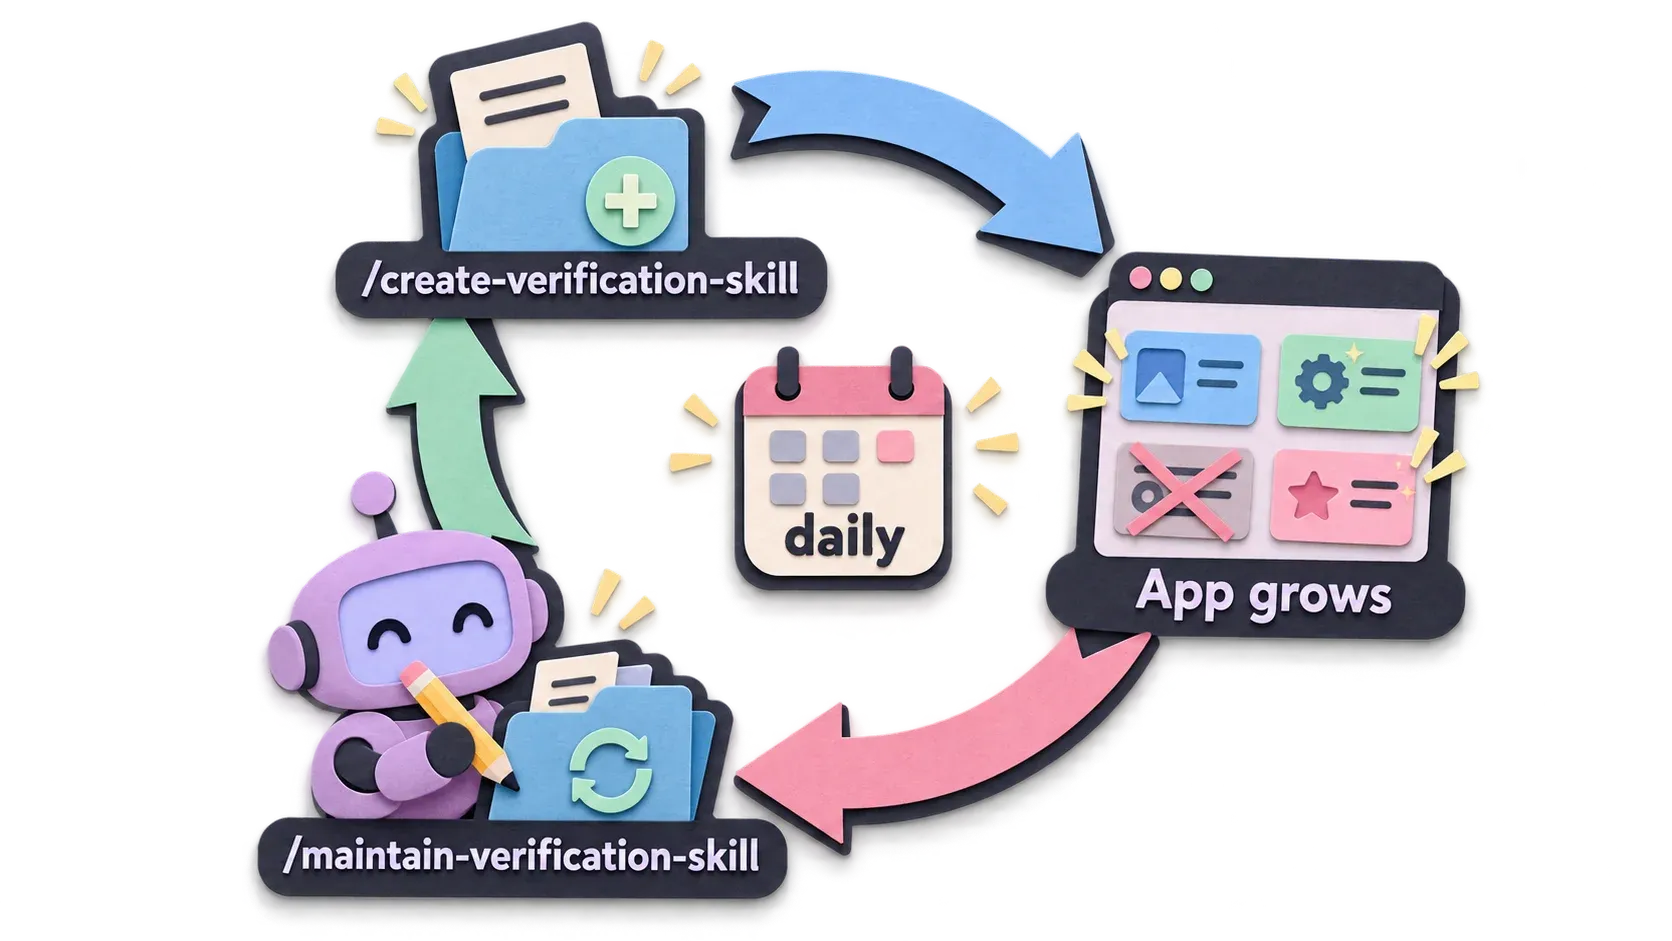
ไฟล์ทั้งหมดอยู่ใน skill folder ของ repo เช่น .cursor/skills/verify-<ชื่อ app>/ (Cursor), .omp/skills/verify-<ชื่อ app>/ (omp) หรือ .agents/skills/verify-<ชื่อ app>/
ส่วน feature map อยู่ใน references/features/ ข้างใน folder เดียวกัน
harness อื่นๆก็อาจจะเก็บใน folder ที่ต่างไป แต่ยังไง Coding agent ก็หาเจออยู่แล้วครับ
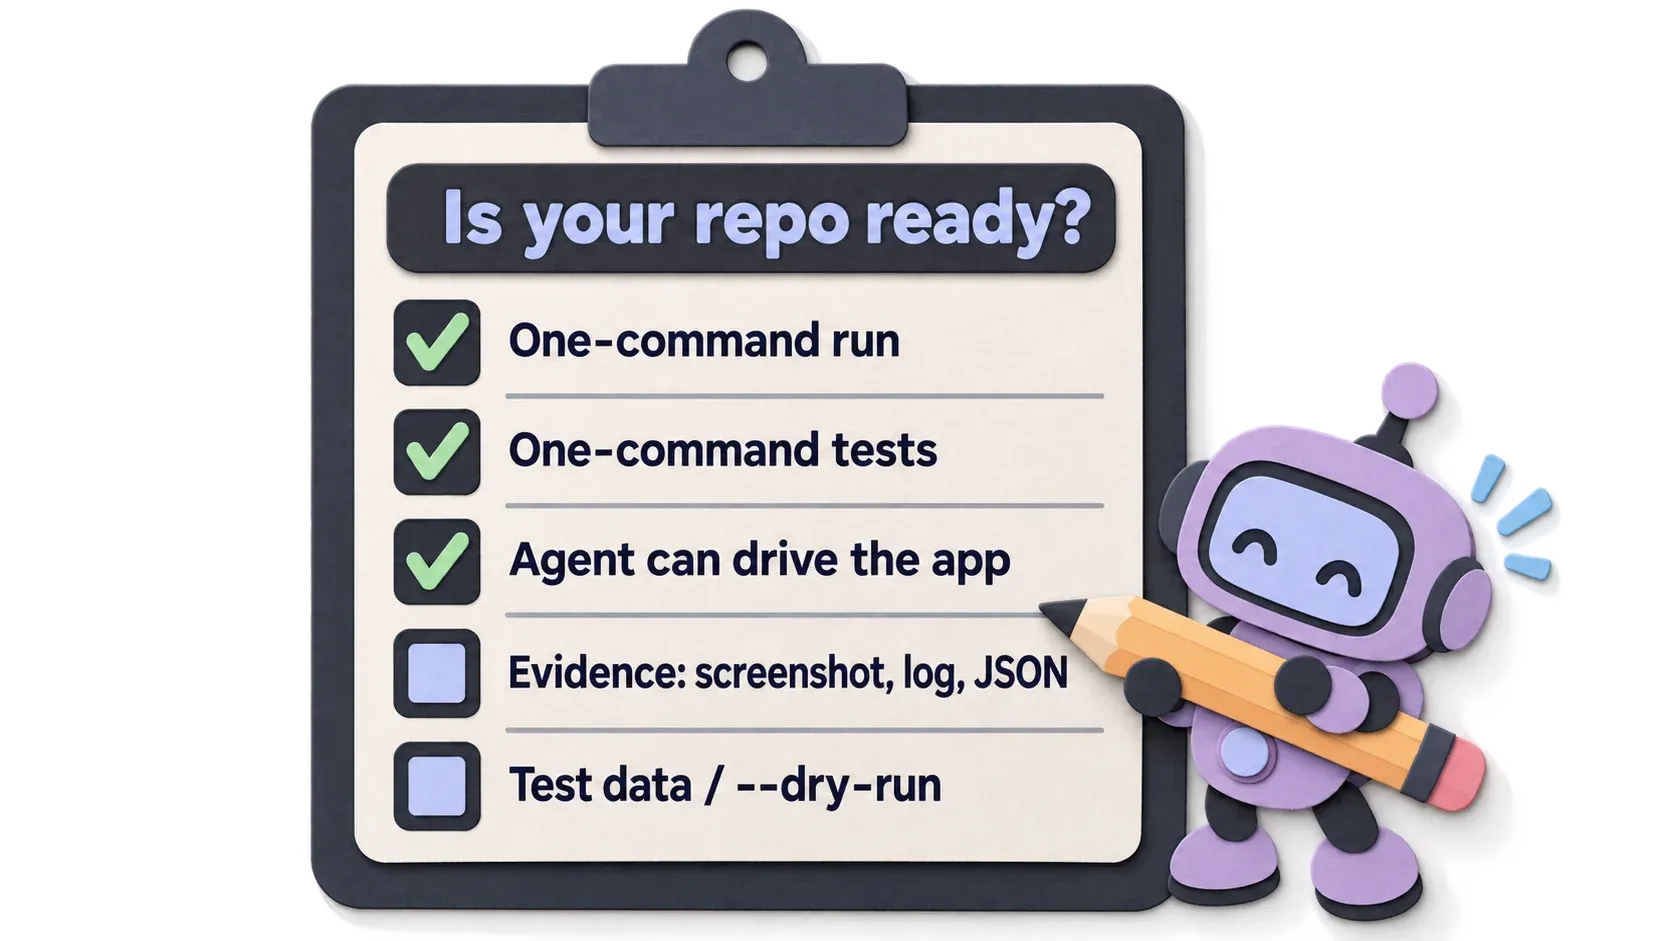
แล้วตอนนี้ repo เราพร้อมให้ agent ตรวจงานตัวเองหรือยัง
ผมมีคำถามให้ลองถามว่าเรามีสิ่งนี้ไหม
- รัน app ขึ้นมาได้ด้วยคำสั่งเดียว โดยไม่ต้องให้คนกดอะไรเพิ่ม
- รัน test ทั้งหมดได้ด้วยคำสั่งเดียว
- agent เปิด app เองได้ (browser, simulator, terminal) และกดใช้งานได้เหมือน user
- agent เก็บหลักฐานกลับมาได้ เช่น screenshot, log, output JSON
- มีข้อมูลทดสอบหรือโหมด
--dry-runที่ทดลองได้โดยไม่ทำของจริงพัง
ถ้ายังตอบ ไม่ สักข้อหนึ่งให้ใช้ /create-verification-skill ครับ
2. ตั้ง Roles
อย่างที่บอกว่า pstack จะใช้หลายๆ models ให้ทำงานอย่างเดียวกัน แล้วเอาผลลัพธ์มารวมกัน หรือเลือกอันที่ดีที่สุดขึ้นอยู่กับงานนั้นๆนะ
pstack เลยใช้ roles เป็นตัวกลาง เช่น role feature, refactoring จับคู่กับ Grok 4.7, role judgment and prose จับคู่กับ Claude Opus 5.5 ในระบบ pstack อ้างถึง role เสมอ เบื้องหลังเราเปลี่ยน model ได้ตามชอบเลย พอมี model ใหม่ออกมาก็แก้ที่เดียว
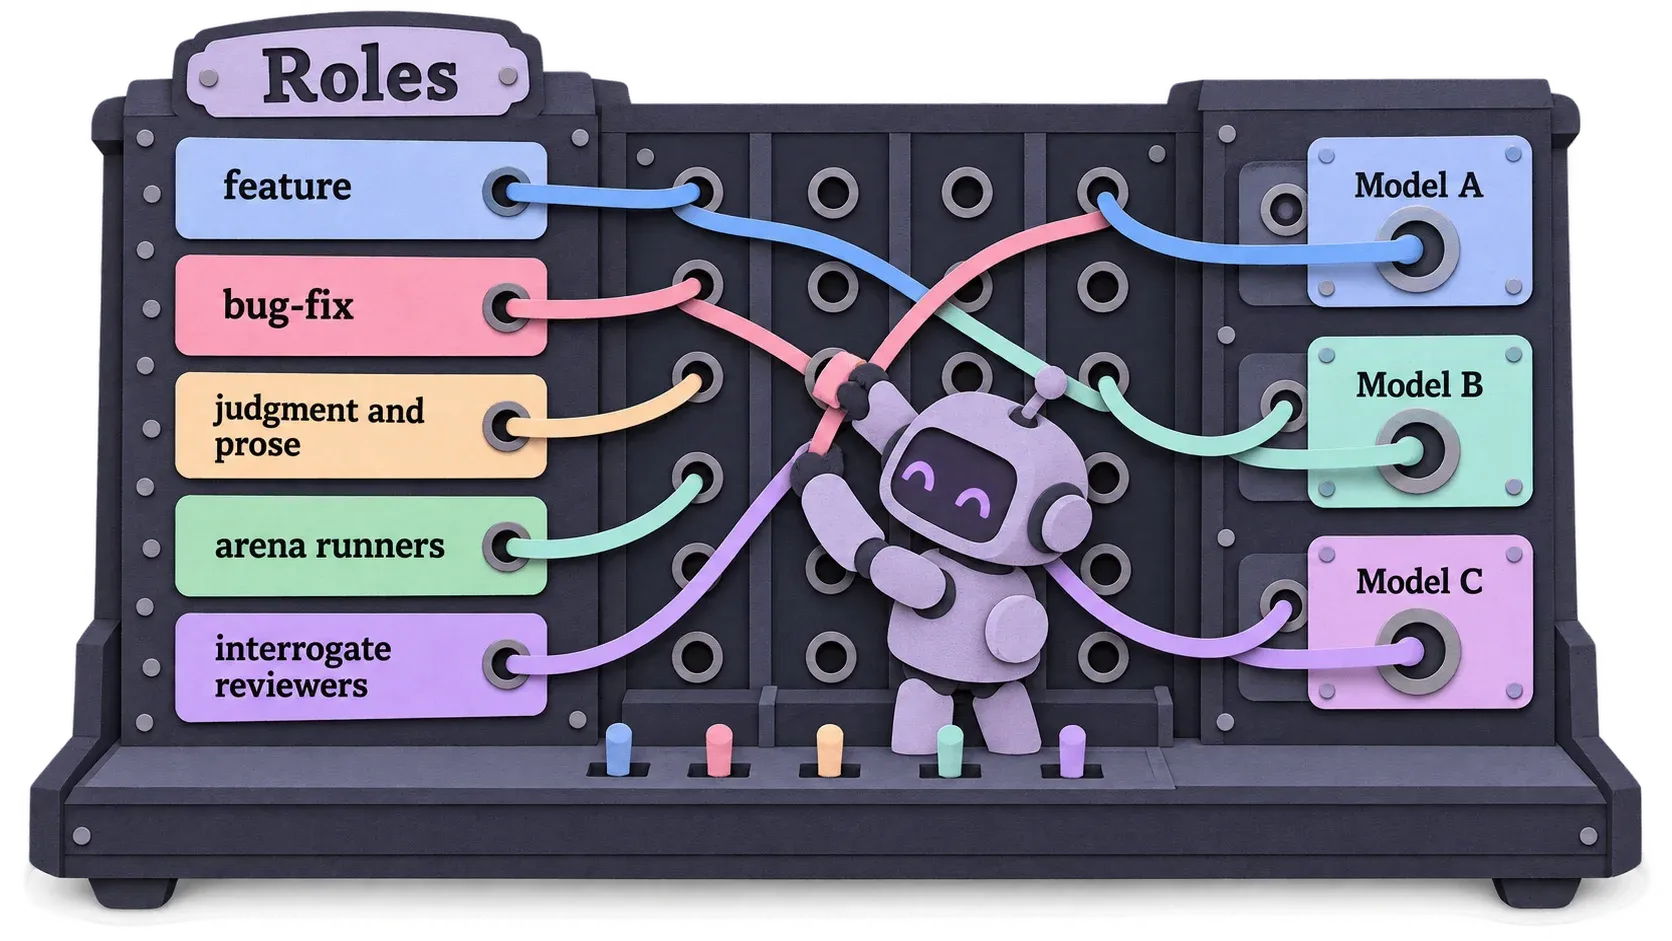
roles มี 17 ตัว แบ่งได้ 5 กลุ่ม
- เขียนโค้ดใน playbook เช่น feature, bug-fix, perf-issue, hillclimb ใช้ model ที่เร็ว
- คิดและตัดสินใจ งานเขียนแผน งานเขียน และงานยากที่สุด ใช้ model เก่งๆไปเลย
- เข้าใจ Code จะใช้ model เล็กๆ ที่เร็ว กับ model ตัวเก่งให้คนอ่านใน
/how/why/reflect - แข่งกันทำงาน กลุ่มนี้จะทำงานแข่งกันโดยใช้หลายๆ models หลายๆค่าย หา candidate และกรรมการใน
/arena/architect - แตกงานและตรวจงาน worker ใน
/swarmและ reviewer ใน/interrogate
ตารางเต็มพร้อม model ที่แนะนำ ดูได้ในท้ายบทความครับ ค่าแนะนำเป็นของคนที่มี model และ token แบบไม่จำกัดอย่างคุณ Lauren Tan ซึ่งใช้เป็นแนวทางเฉยๆนะ ไม่ใช่ข้อบังคับให้ต้องทำตาม (ใครจะทำตามได้เนี่ย)
ถ้าใช้ pstack-claude ตอน setup จะได้ markdown ที่บอกว่า role ไหนใช้ model อะไร แล้ว subagent จะถูกสั่งให้เปิดด้วย model ตามนั้น ข้อเสียคือมันเป็นแค่คำสั่งให้ model อ่าน ไม่มีอะไรการันตีว่าจะทำตามทุกครั้ง
ใน omp ผมผูก agent กับ model role ของ omp ตรงๆ เลือก model ในตัว harness เอง ไม่ต้องหวังให้ model อ่าน markdown แล้วทำตาม เพราะว่า model role นี่เป็น native feature ของ omp เลยครับ พอดีกับสิ่งที่ pstack ต้องการเลยละ ดีโครตๆ ฮ่าๆ ขายของ
มารู้จัก Skills ทั้งหมดใน pstack
หลายๆคนน่าจะคิดว่า Playbook น่าจะสำคัญกว่า ทำไมพูดถึง skills ก่อน ผมมองว่าสำคัญเหมือนๆกันครับ เพราะว่า playbook ประกอบขึ้นจาก skills ครับ จึงควรรู้จัก skills ก่อน ไม่ต้องจำหมดหรอกครับ แค่ผ่านๆตาไว้ก่อน สุดท้าย playbook จะเป็นคนเรียกใช้
อีกเหตุผลคือคุณ Lauren Tan อยากให้เรามี mode ของตัวเอง
เอา skills ของเขามาประกอบเป็น playbook ที่เหมาะกับ project เรา
จนสุดท้ายเรามี mode เป็นของตัวเอง เช่น /my-mode ใช้คู่กับ /poteto-mode ถ้าไม่รู้จัก skills ก็ประกอบ mode ของตัวเองยากน่ะสิ
skill ที่เราใช้บ่อยๆในตอนเริ่มต้น session
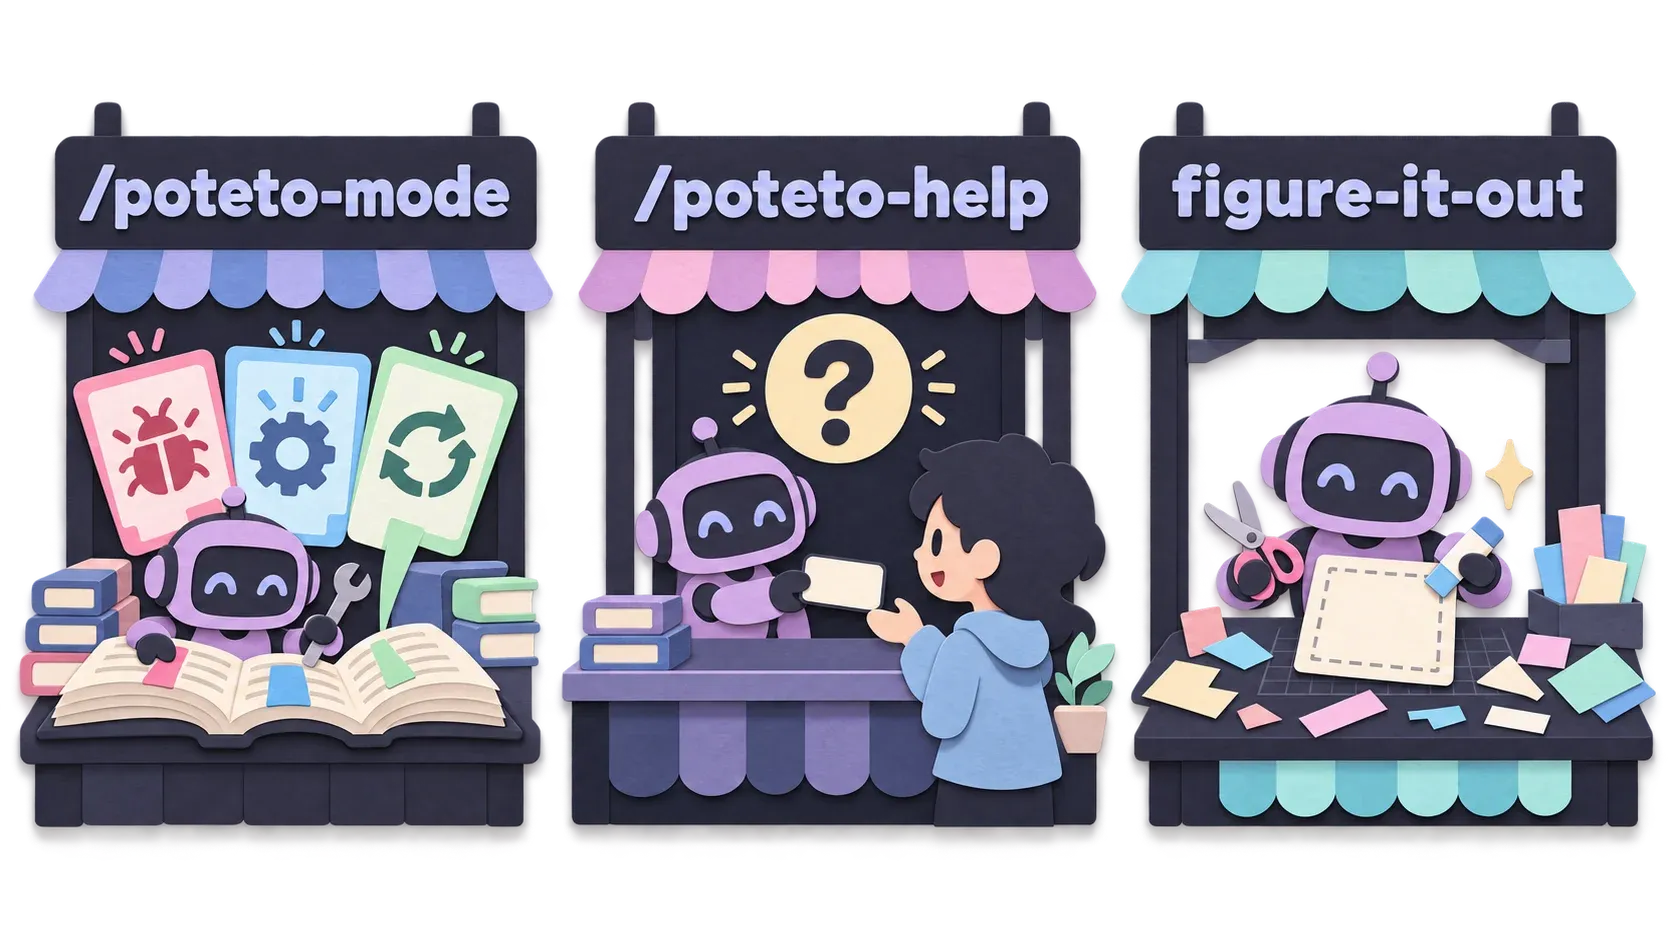
/poteto-modeอันนี้เป็น skill นะ มันจะรวบรวม Playbook ทั้งหมดไว้ เป็นเหมือนสารบัญ Playbook ของ pstack อะ/poteto-helpอันนี้จะเหมือนกับpoteto-modeเลย แต่มันจะไม่ทำงานให้เรา มันจะให้ prompt มาแทน เราต้องเอา prompt ไปใส่ใน session ใหม่แทน เราสามารถปรึกษา pstack ได้ว่าควรใช้ skills ไหนดี เริ่มต้นใช้ pstack ยังไงดี ควรสร้าง verification skill อย่างไร set models อย่างไร ถามได้หมดเลย ถามว่า skills ไหนทำอะไรก็ได้ ให้มันสอนใช้ pstack ก็ได้ด้วย สั่งงาน/poteto-modeไม่ถูก ก็มาถาม/poteto-helpก่อนก็ได้figure-it-outสร้าง playbook ให้เองเมื่อไม่มีตัวไหนเหมาะ (ผมเขียนรายละเอียดไว้ในหัวข้อ figure-it-out ในส่วน Playbook ด้านล่างนะ)
เข้าใจ code base ก่อน
-
/howจะอธิบายว่าระบบทำงานอย่างไร โดยเฉพาะเจาะจงเป็น feature ไปนะ หรือแค่บางส่วนของ feature ก็ได้ขึ้นอยู่กับคำถาม ถ้าคำถามกว้างๆ เช่นถามถึง feature ใหญ่ๆ ต้องการการค้นหาเยอะๆ ก็จะ spawn subagents มาช่วยด้วย -
/whyช่วยหาสาเหตุว่าทำไม code ถึงเขียนออกมาแบบนี้ ส่วนใหญ่แล้ว code จะบอกว่าทำอะไร แต่ไม่ได้บอกว่าทำไมถึงทำแบบนั้นแบบนี้ skill/whyจะช่วยหาให้ สิ่งที่มันไปค้นจะค้นลึกไปถึง git logs, PR ต่างๆ หรือถ้าเชื่อมต่อไปถึงแหล่งเอกสารก็จะค้นทั้งหมดด้วย ระบบ monitor ก็ไป คือต่ออะไรไว้มันจะไปค้นหมดเลย ถ้ามันเยอะก็จะ spawn subagents มาช่วยด้วย -
/teachจะช่วยสอนเราใน code ที่ได้ทำมาอะนะ เบื้องหลังจะใช้ skill/howกับ/whyสามารถใช้ตอนที่ต้อง review PR ได้นะ เพื่อที่จะได้เข้าใจว่าใน review คนทำตั้งใจทำอะไร เพราะอะไร -
/recallอยากรู้ว่างานที่ทำ ทำถึงไหนแล้ว หรือถามถึง feature ก็ได้ว่า feature ทำถึงไหนแล้ว จะต้องทำอะไรต่อ มันจะไปค้น sessions เก่าๆ ค้น git log ค้น PR แล้วตอบคำถามเรา บางครั้งเราหยุดงานไปนาน แล้วลืม/recallก็ช่วยได้นะ
ออกแบบ code
ก่อนไป skill ต่อไป ผมขอพูดถึงการออกแบบกันก่อน มีทั้งออกแบบ UI และ Architecture นะครับ
เวลาเราออกแบบที่เราใช้ Agent ช่วย agent มันก็มันจะเสนอสิ่งที่มันคิดได้ idea แรกออกมา ซึ่งมันอาจจะไม่ใช่แบบที่ดีที่สุดไง ทำให้เราเสียเวลาแก้ซ้ำไปซ้ำมา ไม่มีอะไรคืบหน้า เรายังทำสิ่งเดิมอยู่เลย
คุณ Lauren Tan บอกว่าควรจะทำสิ่งที่รันได้มาหลายๆแบบก่อน ไม่ต้องดี ไม่ต้อง test แล้วให้เราเลือกก่อน ค่อยลงมือทำมันจริงๆ
มี skills 3 ตัวที่ช่วยเรื่องนี้ครับ
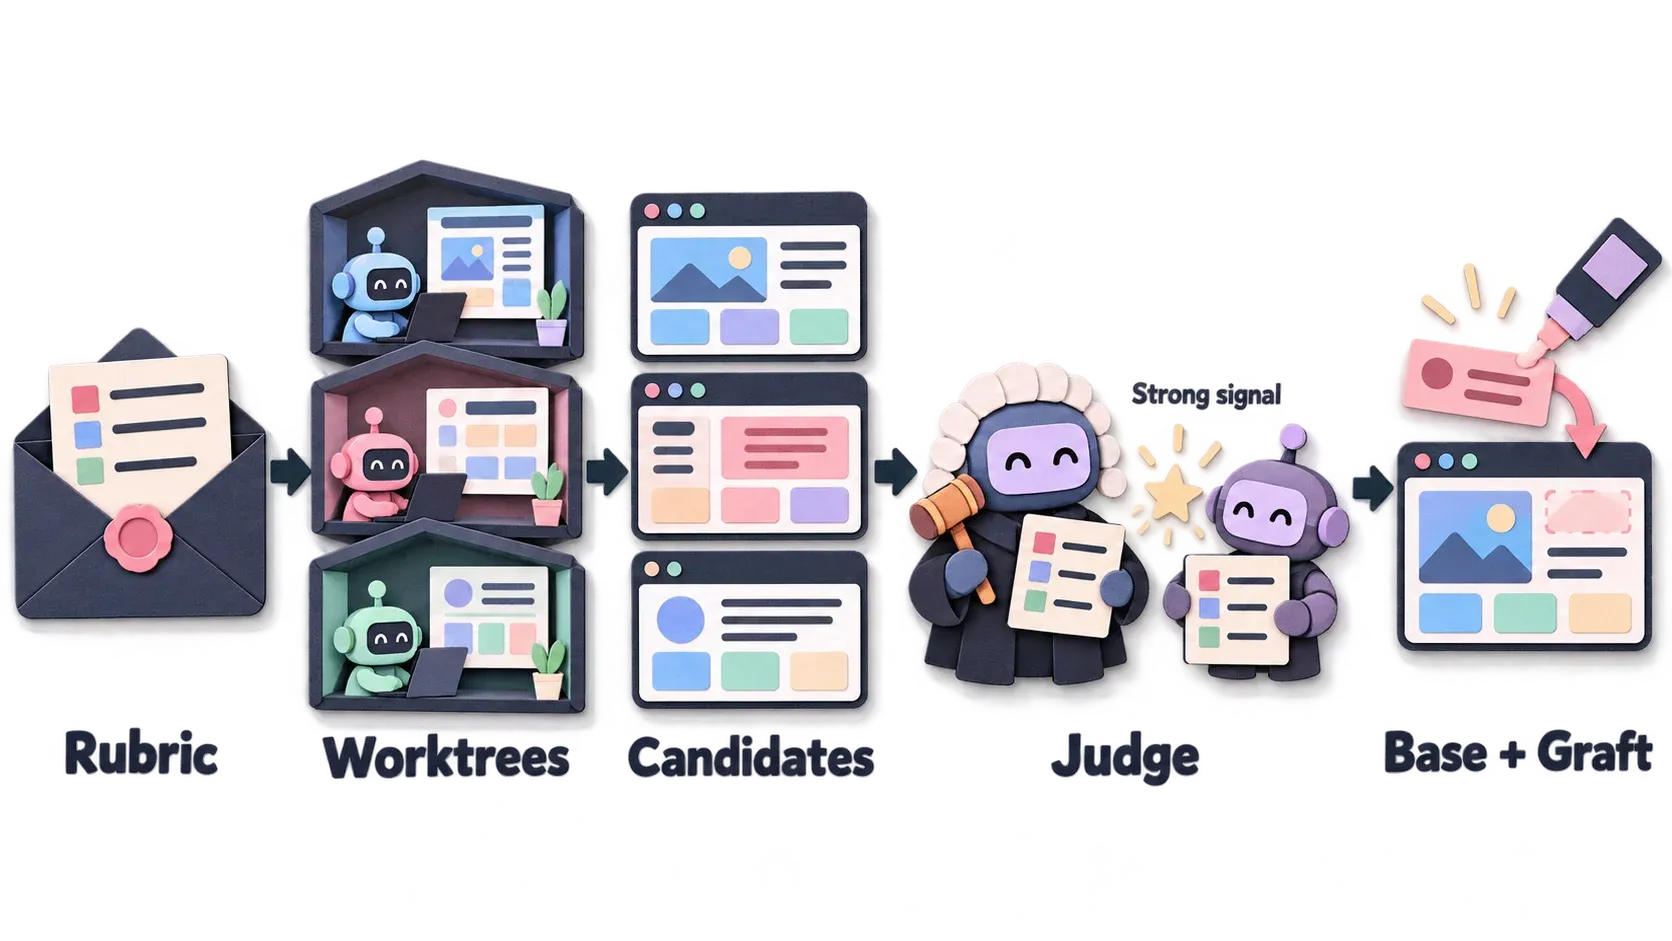
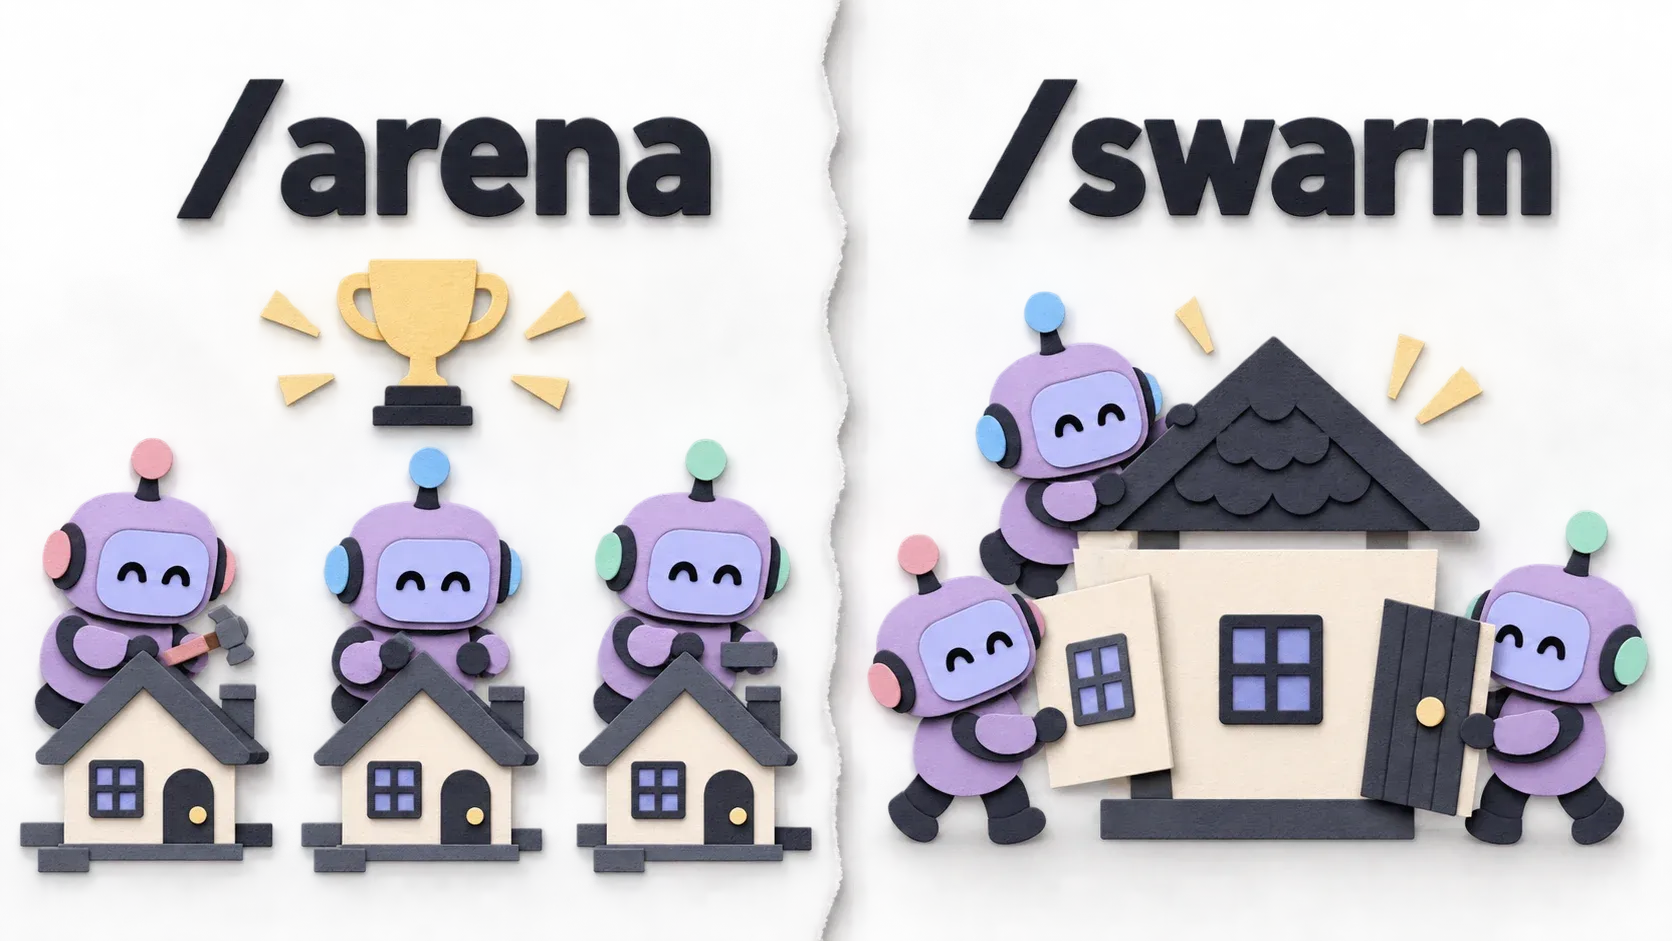
/arena เป็นการแข่งกันเขียนโค้ด agent ตัวหลักส่ง subagent หลายตัว ไปทำงานเดียวกัน เช่นออกแบบ UI ก็จะได้ UI มาหลายแบบ ลำดับคือ
- agent หลักเขียน Rubric (เกณฑ์ให้คะแนน) ไว้ก่อน
- แยก worktree ให้ model แต่ละตัว จะใช้ model ไหนได้บ้างก็อยู่ที่เรา setup ไว้ใน model roles ครับ ใน role
arena runners - ส่ง prompt ไปให้ subagent ทำงาน โดย ไม่บอก rubric งานที่แต่ละตัวส่งกลับมาเรียกว่า Candidate
- Judge กรรมการ 1 ตัว จาก role
arena cross-judge poolกับ agent หลักให้คะแนนตาม rubric ถ้าทั้ง main agent และ กรรมการเห็นตรงกันตรงนั้นจะมีน้ำหนักเลย ถือดี แบบนี้เรียกว่า Strong signal ถ้าเห็นไม่ตรงกันก็จะไปดูเหตุผลของแต่ละคนก่อน แล้วเลือกตัวที่ดีที่สุด - เลือกตัวที่ดีที่สุดเป็น Base แล้วหยิบส่วนที่ดีจาก candidate อื่นมาต่อ เรียกว่า Graft
/architect ตามชื่อเลยคือเอาไว้ออกแบบ code structure ใน skill นี้ยังไปเรียก /how, /why, /arena จุดเด่นคือใช้ /arena ทำให้ได้ของที่ดีที่สุด และขอ checkpoint ได้ด้วยคำว่า with checkpoint พอได้ prototype มันจะรอให้เราเลือกก่อน
ขอ checkpoint คือการขอให้ agent หยุดรอคำตอบจากเราก่อน
เรื่อง function หรือ API ตัว /architect มันจะเขียนฝั่งที่เรียกใช้ (caller) ก่อน แล้วค่อยเขียนตัว function/api (callee)
คุณ Lauren Tan พบว่า เพราะถ้าเริ่มที่ callee Agent มันจะทำให้ code และ api specs สวยแค่ฝั่งตัวเอง แต่ฝั่งคนเรียกใช้งานยาก
/swarm อันนี้จะคล้ายๆ /arena แต่ก็ตรงข้ามด้วย เอ๊ะ ยังไง
/swarm คือแบ่งงานเป็นงานย่อยๆ แล้วให้หลายๆ models แยกกันไปทำ สุดท้ายค่อยเอามารวมกัน โดยงานที่แบ่งเนี่ยจะต้องแบ่งได้จริงๆ ก็เป็นหน้าที่ของ /poteto-mode ให้มันหาจุดนี้เอง
ตรวจงาน
อย่างที่บอกว่า Core idea ของ pstack คือการตรวจงาน
หลังจากที่ AI Agent ทำงานเสร็จ ต้องแน่ใจว่า Users จะใช้งานได้ด้วย ต้องมีหลักฐานด้วย
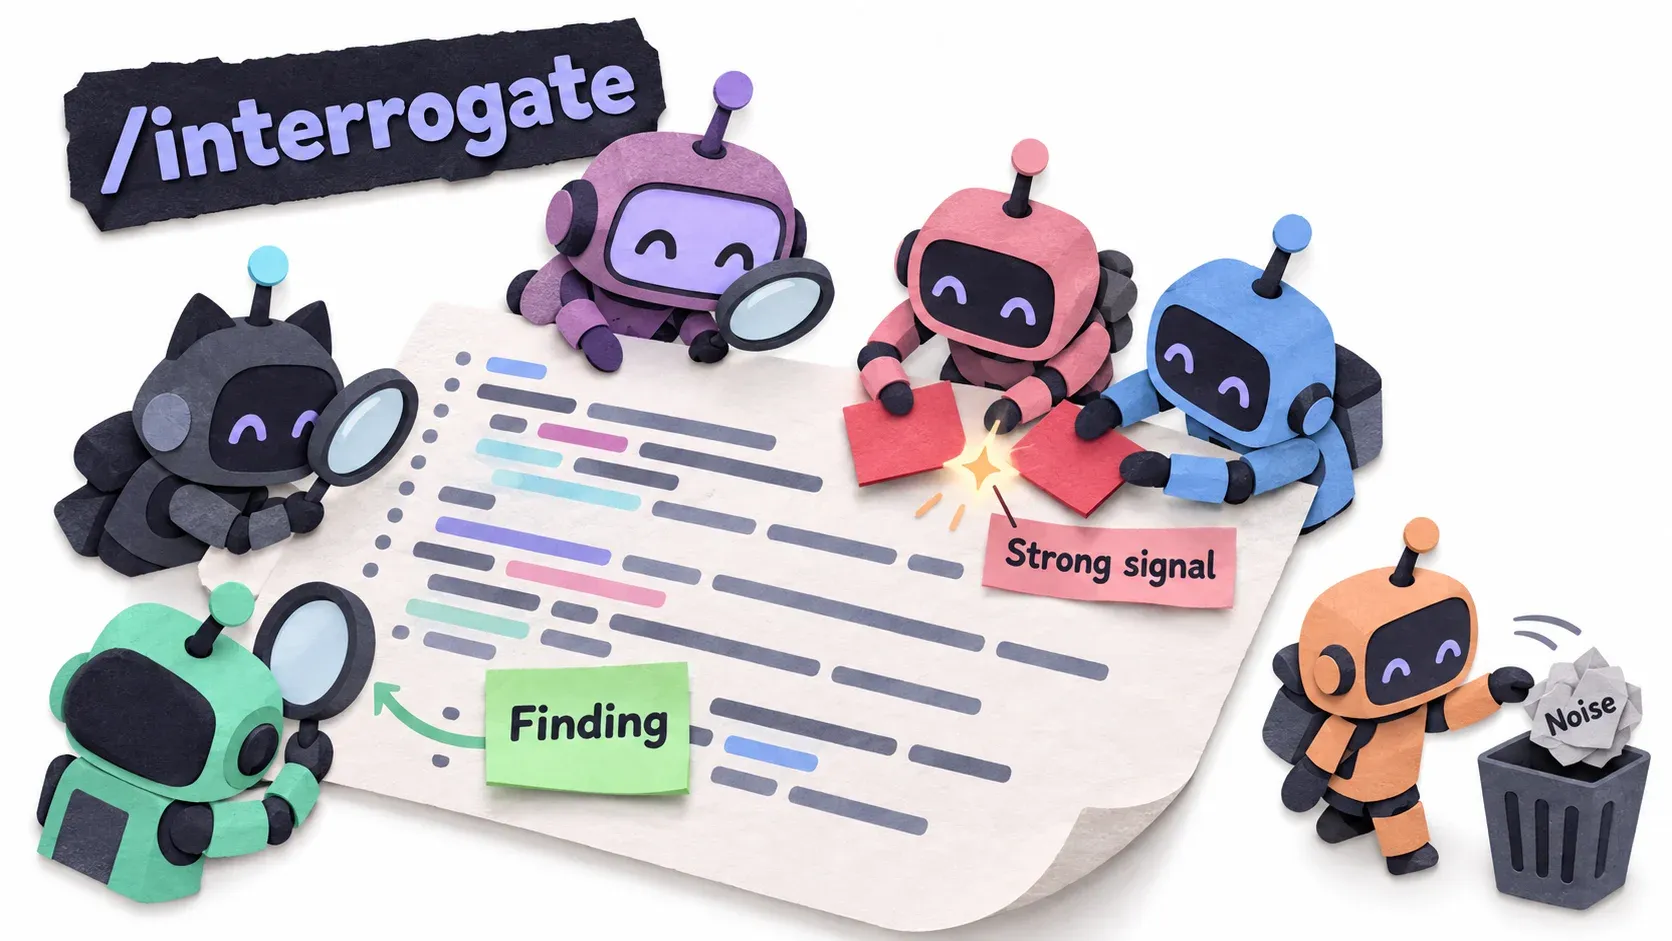
/interrogate ให้หลายๆ model ช่วยกันหาจุดผิดจากงานที่ทำมา ก่อนส่ง PR ก็เปิด subagent หลายตัว ต่างคนต่างหา สิ่งที่แต่ละตัวเจอเรียกว่า Finding ถ้าหลาย model เจอจุดเดียวกันเรียกว่า Strong signal ส่วนที่เจอแต่ไม่ผิดจริงหรือไม่สำคัญ (เช่นชื่อตัวแปรใน test สะกดผิด) เรียกว่า Noise
/create-verification-skill และ /maintain-verification-skill ดูหัวข้อ Setup ข้อ 1 ผมขี้เกียจเขียนซ้ำ
/benchmark-checklist ถ้าเรามีงานอะไรที่เกี่ยวข้องกับตัวเลข เกี่ยวข้องกับ Performance skill นี้จะช่วยหาตัวเลขพวกนั้นให้
/blast-radius หลังจาก Agent แก้ code เสร็จ skill นี้จะช่วยหาว่ามีจุดอื่นๆจุดไหนพังเพราะการแก้ครั้งนี้หรือเปล่า ส่งทุกคนไปช่วยกันหา
เขียน code
/tdd ก็ตามชื่อ น่าจะคุ้นเคยกัน เขียน Test ให้ fail ก่อน แล้วค่อยไปเขียน Code เพื่อให้ Test ผ่าน อันนี้เพื่อนน่าจะคุ้นเคย แต่เป็น tdd ที่ออกแบบมาสำหรับ pstack ละนะ
/no-comments เปิด subagent ให้ model อื่นดู code ที่เสร็จแล้ว แล้วบอกว่า comment ไหนควรลบ เหตุผลคือ comment มักล้าสมัยเร็วกว่าโค้ด และสิ่งที่ comment พยายามบอกมักบังคับได้ดีกว่าด้วย type, test หรือ lint อ่านเพิ่มที่โพสต์ของน้องมาย ThaiType ThaiType Post
/unslop skill นี้ดีมากถูกเรียกใช้จากหลาย Playbook เลยละ skill นี้จะช่วยลบคำของ AI ออกไปจากงานเขียนที่ไม่ใช่ Code อะ เช่น
- README.md
- PR description
- commit message
/typescript-best-practices ใน skill นี้ใส่ typescript best practice ไว้ เราไม่ต้องพิมพ์บอกบ่อยๆ แค่นั้นเอง
/technical-writing เขียนเอกสารเกี่ยวกับ Technical ให้อ่านง่ายๆ
skills ที่ช่วยให้คุยกับ agent ให้รู้เรื่อง
/bro พอ Agent ตอบเรา แล้วเราไม่เข้าใจ ให้ใช้ skill /bro แล้วมันจะตอบคำถามใหม่ ให้เข้าใจง่ายขึ้นเหมือนมี bro (เพื่อน) มาเล่าให้ฟัง
/correct เมื่อเราต้องสั่งงาน Agent ซ้ำๆหลายๆรอบ เราเริ่มรำคาญใช่มะ เช่นบอกว่าตอนเขียน Code ให้ใช้ Service Layer ไม่ใช่ต่อเข้ากับ DB Layer โดยตรง แต่มันก็ยังทำอยู่ดี
ให้เราเรียก /correct แล้วมันจะช่วยเราหาวิธีที่จะทำให้ Agent ไม่ทำแบบเดิมซ้ำๆ อีกรอบ
/ketchup บางครั้งเราสั่งไป Coding agent ทำงานไปเยอะมากๆ มีอะไรพ่นออกมาเต็มไปหมด
เราไม่อ่านกันหรอกใช่มะ แล้วมันก็บอกว่าเสร็จ อาจจะสรุปมานิดหน่อย skill /ketchup นี้จะช่วยเราสรุปสิ่งที่มันทำไป โดยนับจาก message ล่าสุดของเรา
/in-your-own-words อันนี้เอาไว้ช่วยสร้าง prompt นะ เราอาจจะมีอะไรให้มันทำอะ แต่ว่าเราก็พูดไม่ถูกอธิบายไม่ถูก ให้เราเล่าไปเลย พอใช้คู่กับ skill นี้ Agent มันจะเล่าใหม่ด้วยคำพูดของมัน ใช้ตอนที่เราก็ไม่แน่ใจในคำพูดตัวเอง
/sharpen อันนี้ก็เอาไว้ช่วยสร้าง prompt นะ ให้ Agent ช่วยคิดก่อนว่า Expert ตัวจริงเขาจะทำงานนี้อย่างไร เราจะได้คำสั่งงานที่ชัดๆออกมาเลย
/show-me-your-work คือให้ agent สรุปให้หน่อยว่า ทำงานอะไรไปบ้าง คุณ Lauren Tan มักจะใช้ตอนที่สั่งงานทิ้งไว้ข้ามคืน กลับมาตอนเช้าก็ใช้ skill นี้ถามว่างานเป็นอย่างไรบ้าง agent ก็จะไปสรุปมาให้ ถ้าอ่านไม่รู้เรื่องสามารถต่อด้วย /bro ก็ได้นะ
กฎที่อยู่ในรูปของ skills (principles)
ใน pstack จะมี skills อีกเยอะเลยที่ขึ้นต้นด้วยคำว่า principle- ครับ
มันเป็นกฎที่ได้มาจากตอนที่ Agent เคยทำงานพลาด คุณ Lauren Tan ก็เลยเขียนกฎเก็บไว้เป็น skills
พอเป็น skills ก็ดีหน่อยคือถ้างานนั้นไม่ต้องใช้กฎนั้น ก็ไม่ต้องไปอ่านมัน ใช้กฎที่เกี่ยวข้องกับงานอย่างเดียว
ตรงนี้ /poteto-mode เองก็บังคับให้อ่านกฎพวกนี้ก่อนอยู่แล้ว เราแค่อ่านผ่านๆไปก็ได้ครับ เราเพิ่มกฎของเราเองได้ด้วยนะ
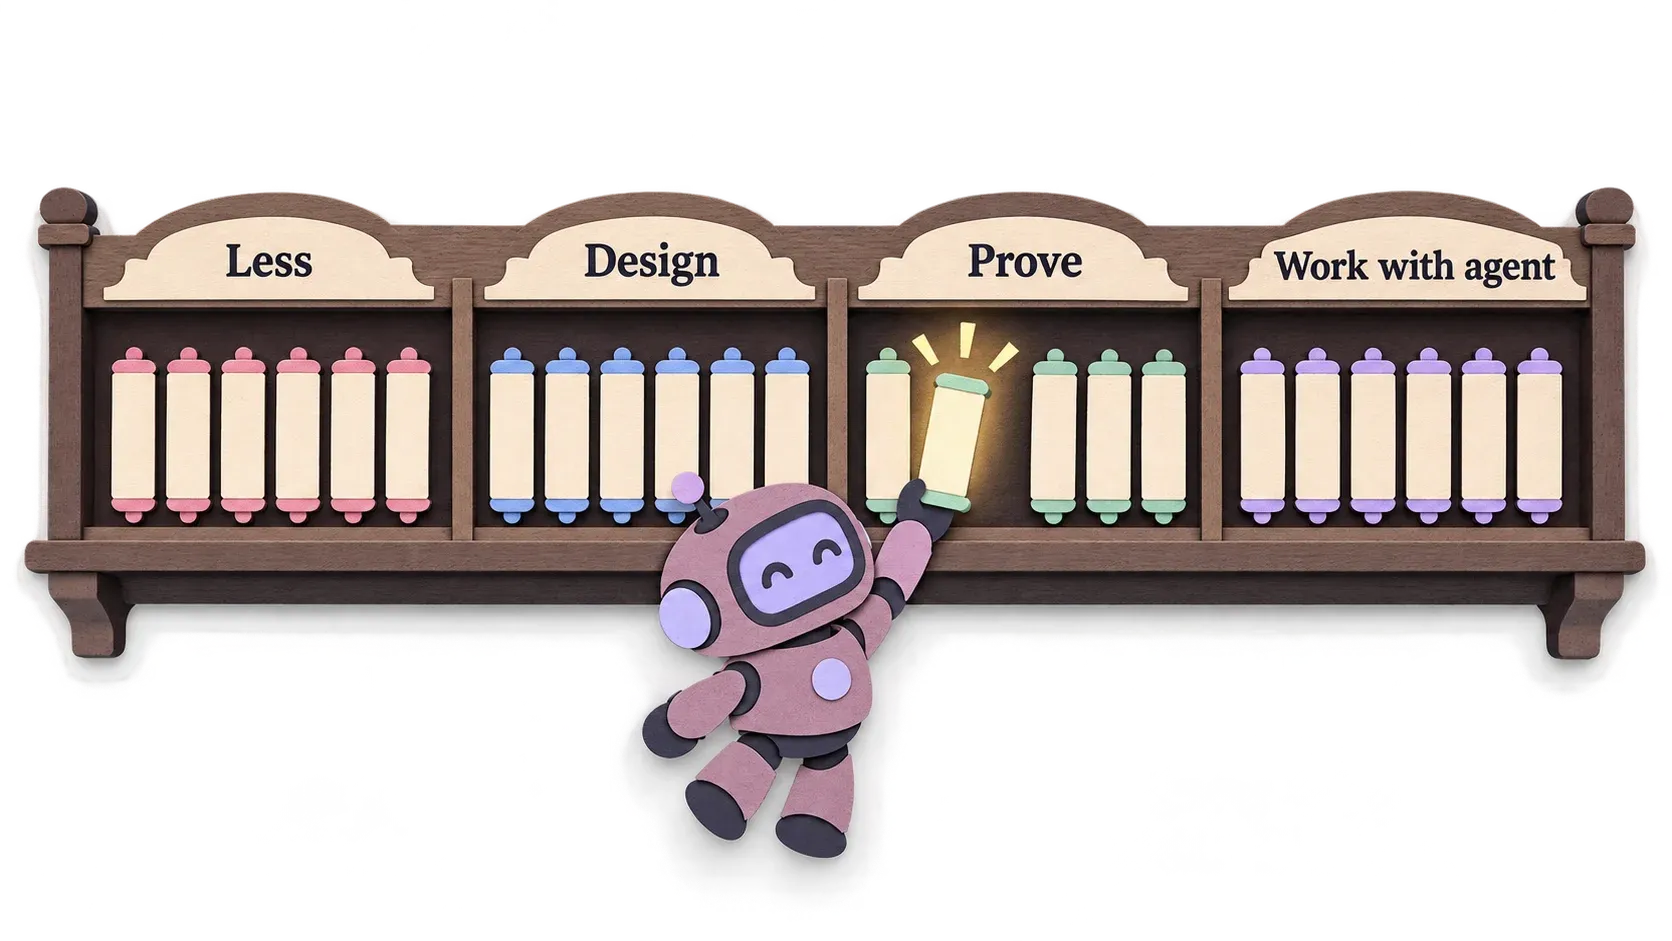
ลดของให้น้อย
lazyiness-protocol feel เหมือนขี้เกียจแบบคนฉลาดอะ แก้ให้น้อยที่สุด ลบอะไรได้ลบเลย ใครรู้จัก Ponytail นั่นแหละ แบบเดียวกัน ตรงนี้ถ้าใครใช้ ponytail อยู่แล้ว จะชนกับ skill นี้ตรงๆ อยากให้ปิด ponytail นะ ถ้าอยากใช้ pstack ซึ่ง omp-plugins ที่ผมทำจะปิดให้เองแบบ auto เลย ถ้าเริ่ม session ใหม่อะนะ
subtract-before-you-add ให้ลบของเก่าก่อน แล้วค่อยเพิ่มของใหม่ ให้ลบอะไรที่จะไม่ใช้ออกไปก่อนแล้วค่อยเขียน code ตามงานที่จะทำ
minimize-reader-load จะช่วยลดความซับซ้อนของ Code ลง เวลาที่มี functions เรียกหลายๆ functions จนกว่าจะได้คำตอบ ถ้าใน code ของเรามีคนใช้ function แค่จุดเดียว มันจะยุบให้เหลือแค่ function เดียว เพื่อลดความซับซ้อนในการอ่าน code ของคน
migrate-caller-then-delete-legacy-apis ถ้าทำ api เส้นใหม่มาใช้แทนของเก่า ก็ไม่ต้องเหลือทิ้งไว้ ไม่ต้องเผื่อเก็บไว้ใช้
outcome-oriented-execution ให้ agent เขียน code ไปได้เลย แม้ว่าระหว่างทางจะมีบาง function พังไป ถ้าเป้าหมายชัด focus ที่เป้าหมายเลย ยกตัวอย่างเช่น เมื่อให้ agent refactor มันอาจจะอยากแยก function เดิมออกเป็น 2 functions แต่มันไม่กล้าลบ function เดิม เพราะเดี๋ยวส่วนอื่นๆจะพัง มันจะไปสร้าง 2 functions ใหม่ก่อน แล้วไม่ลบ function เดิมนี่สิ principle นี้แก้สิ่งนี้แหละ ยอมให้พังไปเลย จะได้ไม่มีขยะ
ออกแบบ
foundation-thinking บังคับให้คิดเรื่อง Data structure ก่อนที่จะคิดเรื่อง logic
model-the-domain บังคับให้ต้องคิดถึง data ของ Biz ก่อน เช่นในระบบมีการแสดงสถานะ เราก็ใช้ if-else ใน code เราหลายๆจุดเพื่อจัดการกับสถานะ กฎนี้บังคับให้ต้องย้ายมันมาไว้ที่เดียวกัน
redesign-from-first-principles เมื่อเรามี features ที่ต้องเพิ่ม ให้ AI ช่วยออกแบบ feature นี้ให้เหมือนกับว่า feature นี้มีอยู่ตั้งแต่แรกเลย
experience-first เน้นผู้ใช้งานก่อนเลย พยายามให้ผู้ใช้งานง่ายที่สุด ส่วน Code มาทีหลัง
exhaust-the-design-space: งานที่ไม่มีตัวอย่าง ทำ prototype 2–3 แบบ
boundary-discipline บังคับให้ validate data ณ ต้นทางที่มันเข้ามาเลย เช่น api รับค่าเข้ามา ก่อนไปทำอย่างอื่นให้ตรวจค่ามันก่อนเลย
type-system-discipline บังคับให้ใช้ประโยชน์จาก type system ให้ได้มากที่สุด
make-operations-idempotent บังคับให้ agent สร้างของที่สามารถทำซ้ำได้ แล้วได้ผลลัพธ์เหมือนเดิมเสมอ ไม่ว่าจะเป็น code หรือ script หรือ tools ต่างๆที่มันต้องสร้าง
ตรวจและพิสูจน์
prove-it-works บังคับให้ verify ของที่ Agent มันทำออกมากับระบบจริงๆเลย ไม่ใช่แค่ lint ผ่านหรือ build ผ่านเพียงอย่างเดียว
fix-root-causes ถ้ามี error ให้หาสาเหตุไม่ใช่ใส่ try-catch แล้วจบงาน
sequence-work-into-verifiable-units ทำทีละนิดทีละหน่อย แล้วลอง verify แล้วค่อยทำสิ่งถัดไป ดีกว่าทำ 20 files แล้วค่อยทดสอบ ย้ำอีกครั้งนี่เป็นกฏของ pstack นะครับ บางคนอาจจะไม่เห็นด้วยกับแนวทาง ก็อยู่ที่มุมมองนะ สุดท้ายก็ไปทำ mode ของตัวเอง /my-mode ดีกว่า ส่วนตัวผมชอบแนวทาง pstack นะ
test-behavior-not-implementation เน้นว่าให้ test สิ่งที่ user จะเห็น ไม่ใช่แค่ไส้ใน (ผมไม่รู้จะใช้คำไหนดี) ทำให้ app มันพังเพราะ user ทำพัง (กรณีมี bugs) app จะไม่ได้พังเพราะเราย้ายโค้ด อันนี้อธิบายยากจัง ผมต้องขออภัย
explain-the-number ก่อนจะเชื่อตัวเลขในเรื่อง performance / benchmarks ต่างๆ ต้องบอกได้ว่าอะไรที่ทำให้ตัวเลขมาถึงระดับนี้ และต้องมั่นใจด้วยว่าวัดถูกตัวนะ
ทำงานกับ agent
build-the-lever ให้ AI สร้างเครื่องมือขึ้นมาช่วยทำงานเดิมซ้ำๆ ทำเป็น script เก็บไว้เลย
attack-the-premise ถ้า AI มันทำงานพลาด 2 ครั้ง ให้หยุดถามตัวเองก่อนว่า สิ่งที่มันตั้งใจจะทำ มันผิดมาตั้งแต่แรกเลยหรือเปล่า แล้วให้ทดสอบสิ่งนั้นก่อนด้วยวิธีง่ายๆ แล้วค่อยลงมือแก้ครั้งที่ 3
separate-before-serializing-shared-state กฏนี้มักจะใช้กับ /arena หรือ /architect ที่จะปล่อย subagents ไปทำงาน แทนที่ subagents จะต้องรอ subagent อีกตัวทำงาน ก็ให้เปิด worktree ดีกว่า
guard-the-context-window ถ้ามีงานที่ต้อง read เยอะๆ เช่นหาอะไรบางอย่างในโค้ด ทำความเข้าใจ code ให้เปิด subagents ไปช่วยกันอ่าน แล้วค่อยสรุปมาทีเดียว เพื่อที่จะได้ไม่ทำให้ context window มันมีพื้นที่น้อยลงส่งผลให้เข้า dump zone เร็วขึ้นอีก
never-block-on-the-human: งานที่ย้อนกลับได้ ทำไปเลยไม่ต้องรอถาม
encode-lessons-in-structure เป็นกฎที่ใช้กับ /correct ถ้าต้องบอกอะไรซ้ำ 2 ให้ใช้ type/lint/check หรือ script เพื่อบังคับแทน
skill ที่ช่วยสร้าง mode ของเราเอง
/automate-me ให้ Coding agent อ่านประวัติ chat ของเราในทุกๆ sessions แล้วหานิสัยการทำงานของเรา แล้วมันจะช่วยสร้าง mode ของเราเอง เช่น /my-mode
/reflect เมื่อเราทำงานอะไรจบ หากเรียก /reflect มันจะส่งประวัติการ chat ให้ reviewer subagent 3 ตัวอ่าน แล้วดูว่ามีปัญหาอะไรในการทำงาน แล้วเสนอให้สร้าง skill หรือแก้ skill เพื่อให้ครั้งต่อไปไม่เจออีก คล้าย skill /retro ของพี่ Matt เลย น่าจะต้องมีคนลอกการบ้าน ฮ่าๆ ผมคิดว่าพี่ Matt ลอกการบ้านนะ ฮ่าๆ ก็แกทำออกมาทีหลังคลิปที่แกสัมภาษณ์คุณ Lauren Tan อะ
มารู้จัก Playbook กัน
Playbook เป็นการรวบรวมขั้นตอนต่างๆไว้ชัดเจนเลย สำหรับงานนั้นๆ เหมือนสูตรอาหารอะ
ปกติแล้วงานของ developer ก็จะแยกออกได้หลายแบบเช่น แก้ bugs, ทำ features, ปรับปรุงความเร็ว แก้ app ช้า, refactor เพื่อให้ maintain ได้ง่ายๆ, อื่นๆ อีกมากมาย
แต่ละงานก็จะมีขั้นตอนต่างกันไปใช่มะ
ตรงนี้คุณ Lauren Tan ก็แบ่งแบบเดียวกัน แล้วก็บันทึกขั้นตอนต่างๆไว้สำหรับงานนั้นๆ เรียกงานต่างๆเหล่านั้นว่า Playbook เมื่อเราต้องทำงานแก้ bugs เราก็แค่หยิบ playbook ของการแก้ bugs มาใช้ ทำตามขั้นตอนนั้นซะ
ย้ำอีกทีว่า Playbook มีขั้นตอน steps แบบชัดเจนเขียนไว้แล้ว
วิธีใช้ /poteto-mode แบบถูกต้อง
การใช้งาน playbook จะต้องใช้ผ่าน /poteto-mode ให้มันเลือก Playbook ให้ครับ
บอกแค่ว่าเจออะไร และอยากได้อะไร ไม่ต้องบอกขั้นตอน และไม่ต้องบอกสมมติฐานของเรา ให้มันไปหาก่อน เราอาจจะมีในใจแหละว่าเอ๊ะตรงนั้นแน่ๆเลยให้พักไว้ในใจก่อน แล้วค่อยดูว่าตรงกับที่เราคิดหรือเปล่า
เหตุผลคือขั้นตอนที่เราบอกอาจขัดกับ playbook หรือบอกไม่ครบ และสมมติฐานของเราจะดึงให้ agent ไปหาตรงนั้นก่อน ซึ่งเราก็ยังไม่รู้ไงว่าสมมติฐานของเรามันถูกหรือเปล่า AI มันก็ดันชอบไง มันจะเอาใจเราอะ มันก็จะไปหาตรงที่เราบอก
ตัวอย่าง ❌ บอกขั้นตอนและสมมติฐาน
/poteto-mode กดปุ่ม Send สองครั้งเร็วๆ แล้วลูกค้าได้ email 2 ฉบับ น่าจะเป็นที่ debounce ใน SendButton repro ก่อน แล้วค่อยแก้และ verify✅ บอกแค่อาการกับสิ่งที่อยากได้
/poteto-mode กดปุ่ม Send สองครั้งเร็วๆ แล้วลูกค้าได้ email 2 ฉบับ อยากให้ได้ฉบับเดียว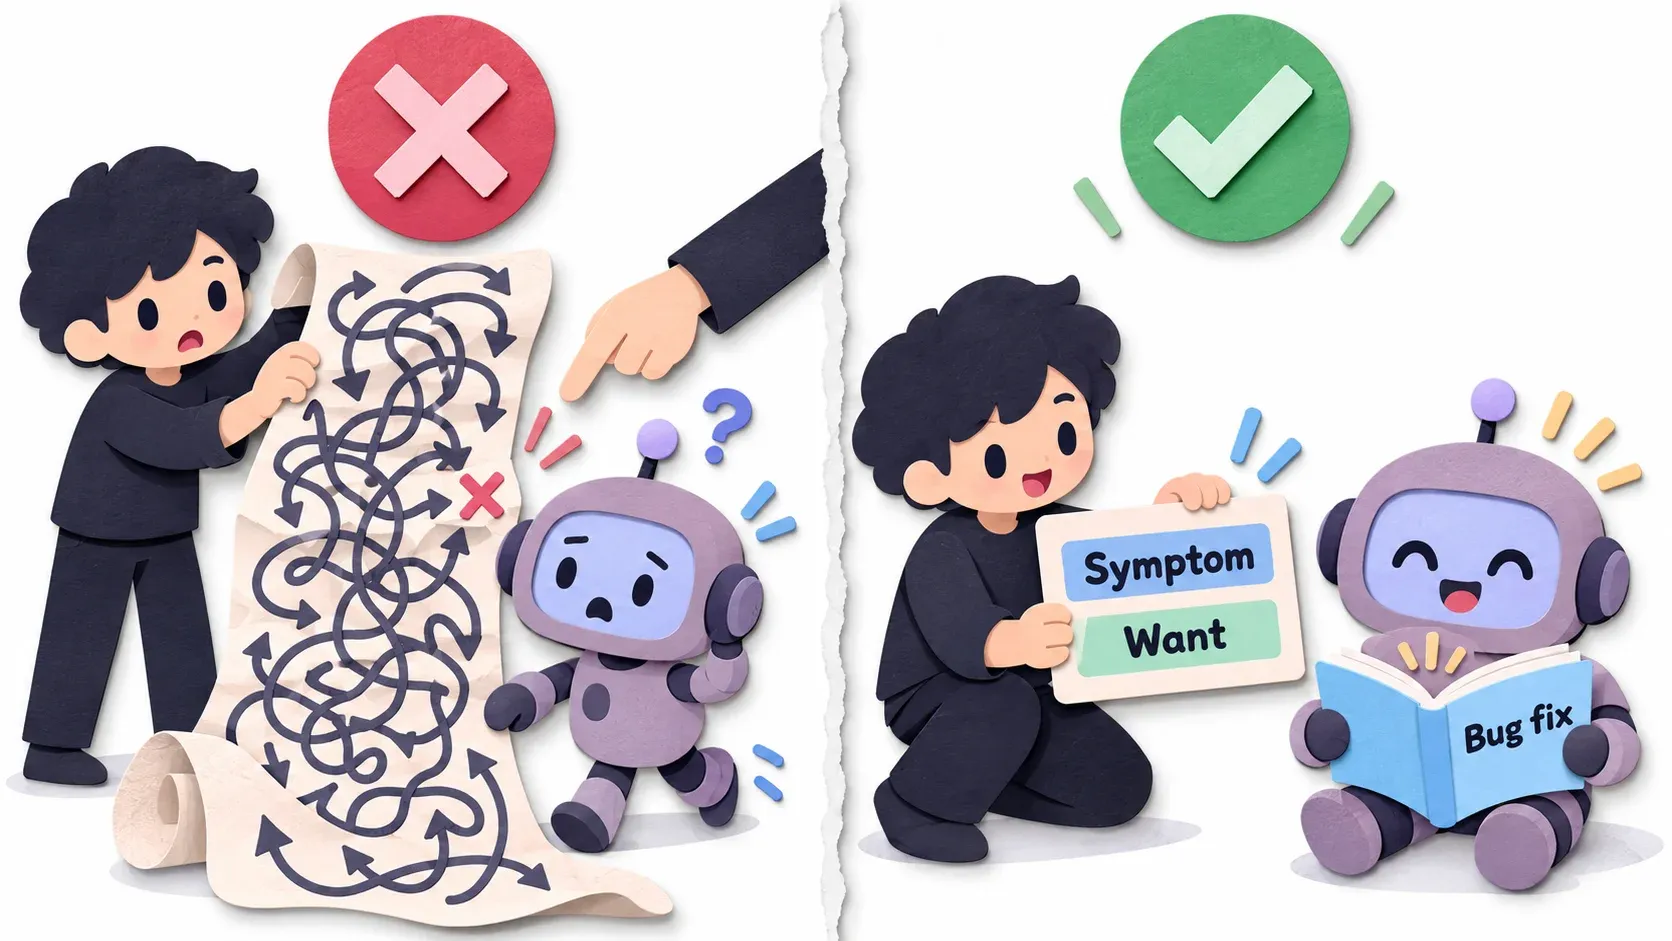
ตรงนี้เมื่อ /poteto-mode อ่านแล้วก็รู้เลยว่าเป็น bug มันก็จะไปหยิบ playbook Bug fix มาแล้วเอาขั้นตอนทั้งหมดใน playbook ใส่ลง TODO list แบบ copy-paste ทุกขั้นตอน แล้วทำตามให้ครบ
ตัวอย่างนะ มี list ประมาณนี้ (ผมแปลเป็นไทยให้อ่านง่าย ของจริงจะเป็นภาษาอังกฤษตาม playbook คำต่อคำ ไม่ถูกแก้คำ)
[x] 1. Repro บนหน้าเว็บเอง: กด Send 2 ครั้ง → ได้ 2 ฉบับ เกิดซ้ำ 5/5 ครั้ง[x] 2. หา root cause: ตั้ง hypothesis 3 ข้อ แล้วตัดทีละข้อด้วย log[ ] 3. วางแผนแก้ (ถ้าแก้หลายไฟล์ ใช้ /architect)[ ] 4. Verify บนหน้าเว็บเดิม: กด Send 2 ครั้ง → ต้องได้ 1 ฉบับ[ ] 5. เรียง commit: test ที่ fail มาก่อน ตามด้วย commit ที่แก้[ ] 6. เปิด PRที่ต้องให้ copy - paste ลง TODO list ก็เพราะว่า AI Agent มันมักจะข้ามขั้นตอนที่มันคิดว่าไม่จำเป็นต้องทำก็ได้ออกไป แล้วส่วนใหญ่มันจะเข้าใจไปเองว่าไม่จำเป็น ก็เลยตัดขั้นตอนเหล่านั้นออกไป นี่เป็นอีกหนึ่งจุดเด่นของ pstack เลยนะ
สิ่งที่ /poteto-mode ใส่ใน TODO list มี 3 ประเภท
- ขั้นตอนจาก playbook คำต่อคำ
- todo ที่ agent คิดเองสำหรับงานนี้โดยเฉพาะ เพิ่มมาจากใน Playbook
- todo ที่ playbook สั่งให้เพิ่มอีกทีนึง เช่น throughput checkpoint 4 ข้อในตัวอย่างข้างล่าง
ข้อไหนไม่ทำ ห้ามลบทิ้ง ต้องเขียนเหตุผลไว้ (skip: หรือ n/a:)
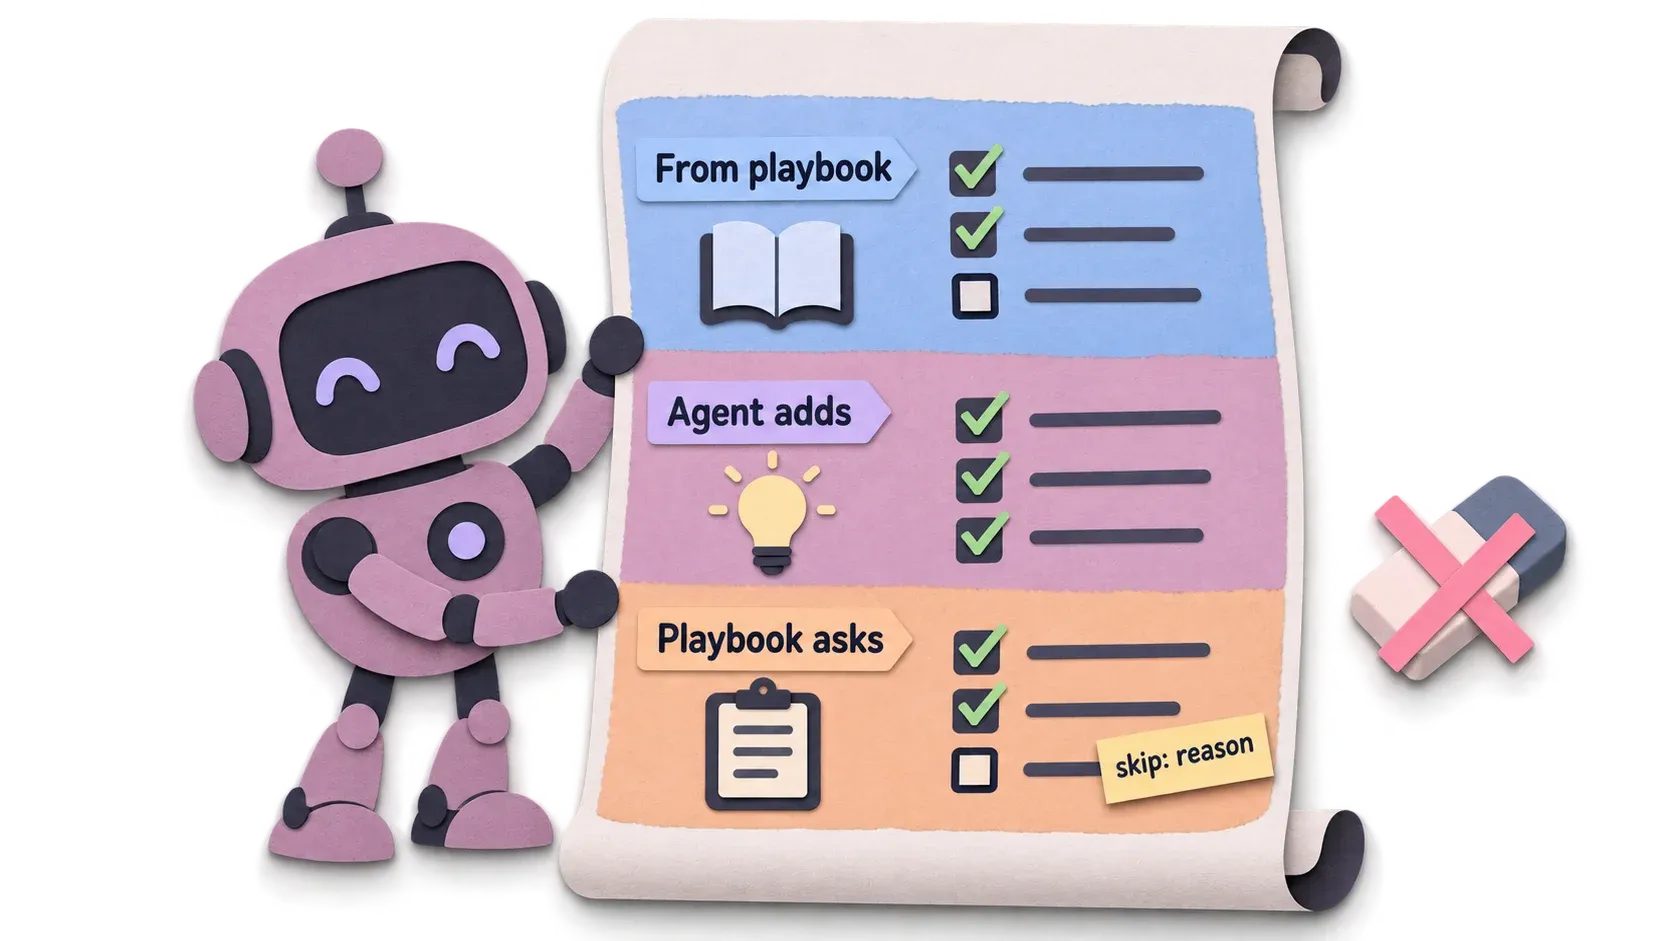
ตัวอย่าง TODO List ของการสร้าง feature ไม่ต้องสนใจเนื้อหาก็ได้ อยากให้เห็นภาพเฉยๆว่าแต่ละส่วนมันจะมี TODO List แบบไหน
— ส่วนที่ 1: ขั้นตอนจาก playbook Feature (คัดลอกคำต่อคำ)[x] 1. how over the affected subsystem.[x] 2. architect for parallel design exploration.[x] 3. Write the throughput checkpoint as four todo items. ...[ ] 4. Delegate code-writing to a subagent ...[ ] 5. Verify on the matching surface. ...[ ] 6. Rebase into small, ordered commits. Stack follow-ups. ...[ ] 7. If the design is contested, interrogate before shipping.       skip: ดีไซน์ผู้ใช้ตกลงแล้ว[ ] 8. Run Opening a PR.
— ส่วนที่ 2: todo ที่ agent คิดเองสำหรับงานนี้[ ] เพิ่ม flag --json ใน cli/args.ts[ ] เขียนฟังก์ชันแปลงผลเป็น JSON ใน export/format.ts[ ] เทียบ output แบบ text ก่อน/หลังว่าเหมือนเดิมทุก byte[ ] รันทั้งสองแบบกับ sample project แล้วเก็บ output เป็น evidence
— ส่วนที่ 3: todo ที่ขั้น 3 สั่งให้เพิ่ม (throughput checkpoint)[x] Blocking first steps: ต้องตกลงรูปแบบ JSON ก่อนเขียนโค้ด[x] Independent workstreams: n/a: แก้แค่ 2 ไฟล์ ไม่มีงานแยกขนาน[x] Shared mutable state: n/a: ไม่มี state ที่แชร์กัน[x] Smallest safe decomposition: subagent ตัวเดียวพอ เพราะงานเล็ก
มารู้จัก Playbook แต่ละตัว
มีเยอะมาก ผมไม่ได้นับอะนะ
ผมแบ่งออกเป็นตัวที่น่าจะได้ใช้บ่อยกับไม่ค่อยได้ใช้นะครับ เผื่อใครอยากอ่านผ่านๆ ก็ข้ามไปได้ครับ
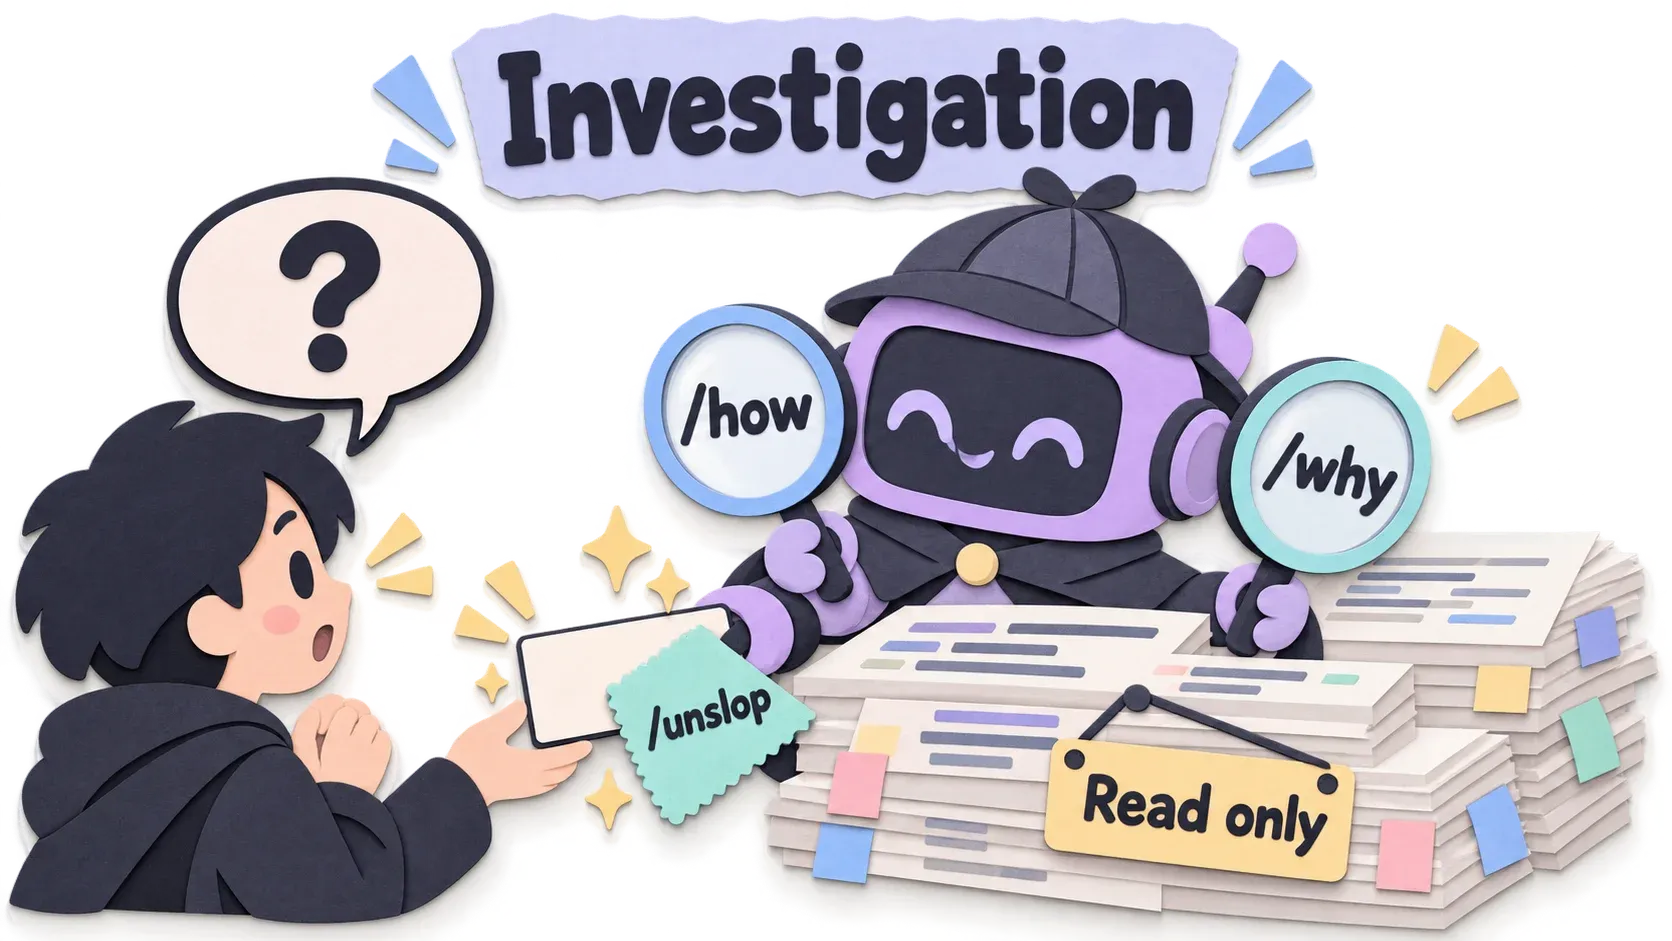
Investigation
playbook นี้จะใช้เมื่อเราถามคำถาม ไม่อยากให้แก้ code อะ
เช่นถามว่า “ส่วนนี้ทำงานยังไง ยังไม่ต้องแก้ code นะ”
ซึ่ง investigation playbook ก็จะไปเรียก skill เช่น /how, /why เพื่ออธิบายระบบ พอได้คำตอบก็จะเรียก /unslop เพื่อเกลาคำตอบให้ดูเหมือนมนุษย์หน่อย
Bug fix
ตามชื่อเลย ใช้แก้ bug ไง
เช่น user กดปุ่ม send email แบบ double click แล้วก็ได้ email เหมือนกัน 2 ฉบับ
Bug fix playbook จะ reproduce ปัญหาก่อน แล้วใช้ /how, /why ตั้งสมมติฐานว่าเป็นที่อะไร ถ้าต้องแก้หลายจุดก็ใช้ /architect ให้ subagent เขียนแข่งกัน เขียน fix ด้วย /tdd แล้วปิดด้วย Opening a PR
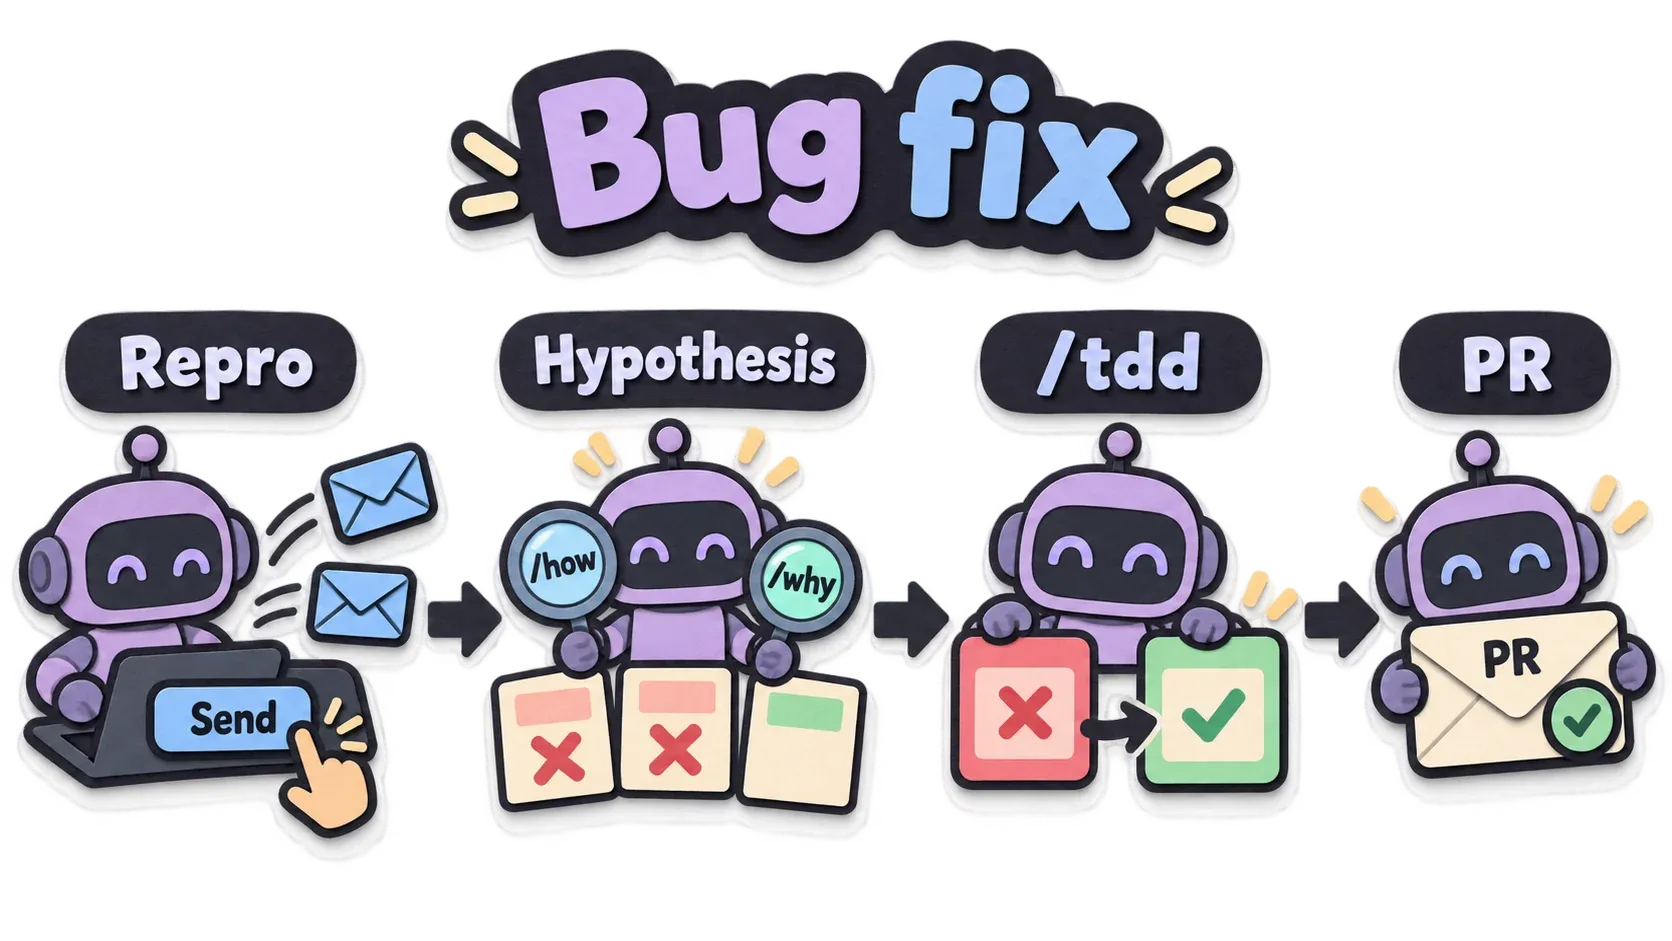
Feature
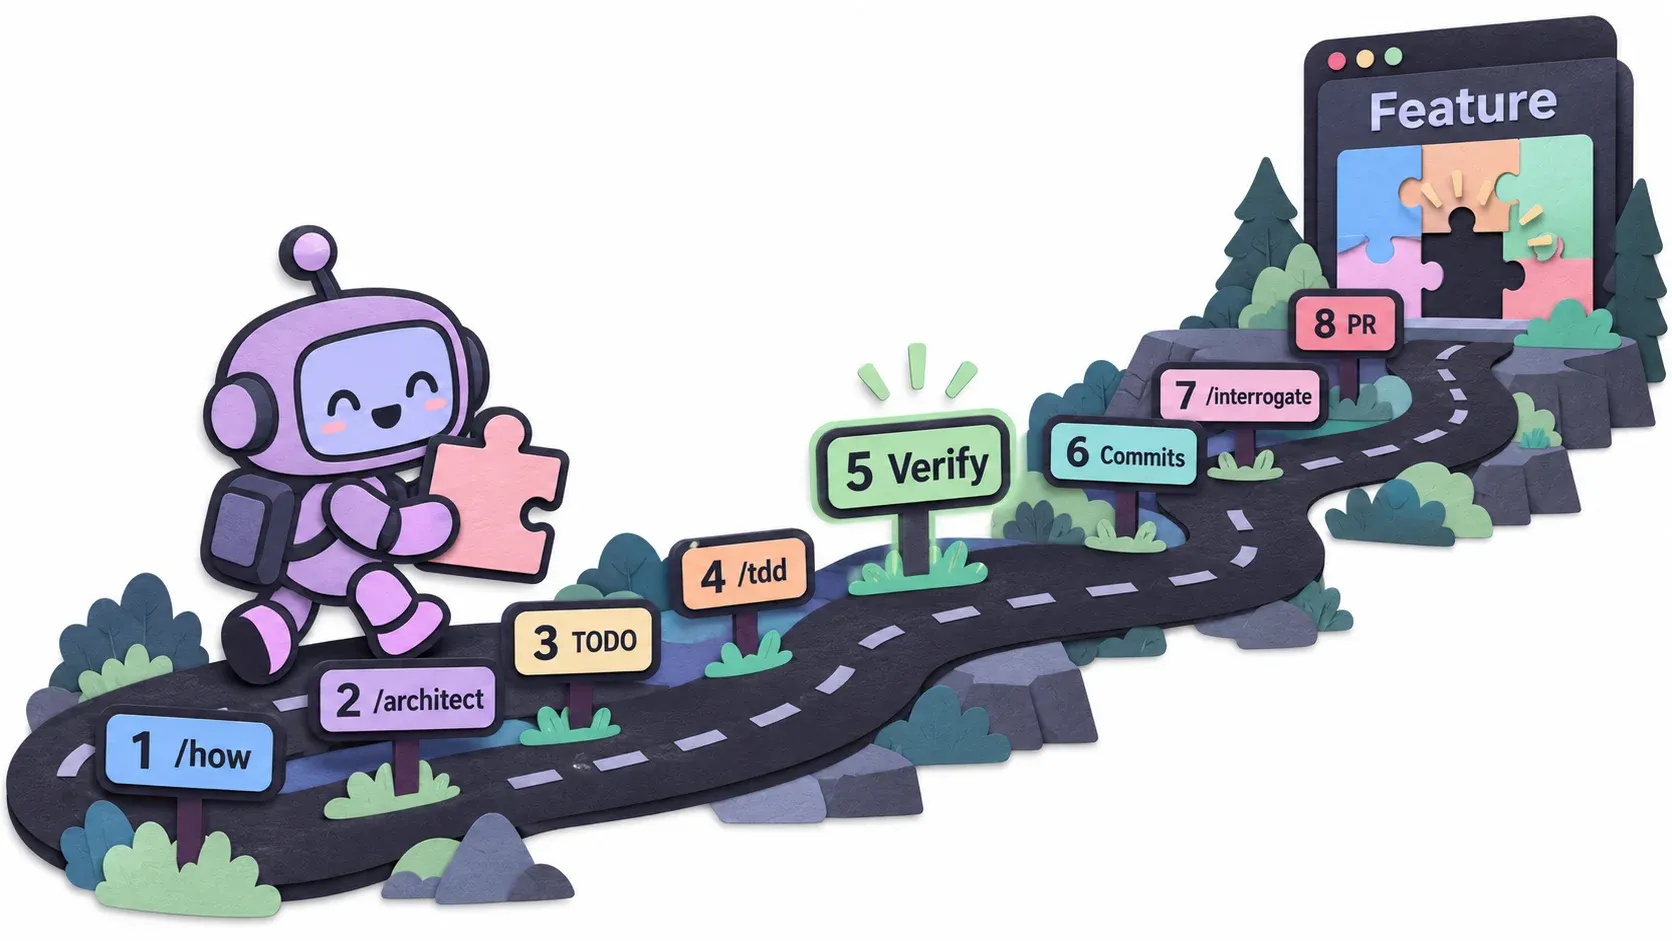
ก็ตามชื่อเหมือนกัน เอาไว้ใช้ตอนอยากเพิ่ม feature ไง feature playbook ก็จะทำ
- ไปเรียก skill
/howเพื่อดูส่วนที่เกี่ยวข้องต่างๆ - ใช้
/architectไปแข่งกันออกแบบ - ได้ผลมาแล้วจะเอาจริงละ ก็จะเขียน todo list
- ส่ง subagents ไปทำงานด้วย
/tddถ้าเขียนได้หลายแบบ มันจะใช้/arenaแข่งกันอีกภายใน - verify งาน
- จัด commits เป็น commit เล็กๆ
- ใช้
/interrogateอีกรอบเพื่อให้มั่นใจ - เปิด PR
Refactoring
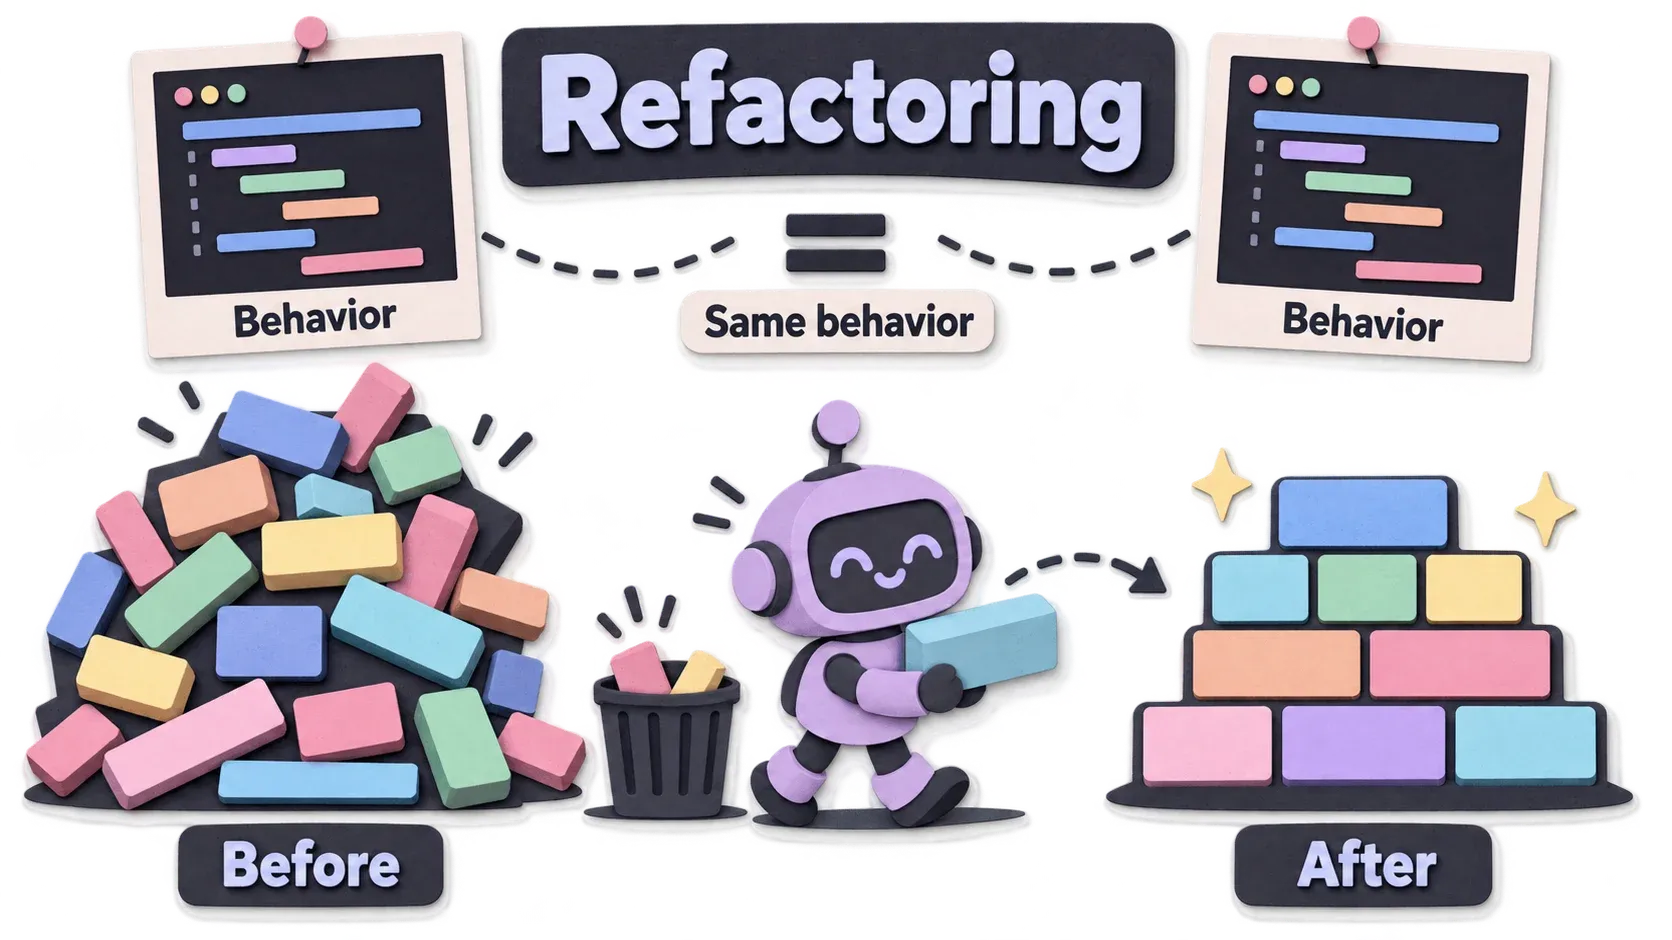
ช่วย refactor code อะตามชื่อ จะทำตามนี้
- ใช้
/howเพื่อหาก่อนว่า behavior ของระบบเป็นอย่างไร แล้วบันทึกไว้ก่อน - ใช้ principle
model-the-domainเพื่อหาว่า code ของเราขาดโครงสร้างอะไรที่สำคัญหรือเปล่า - ก็ใช้
/architectช่วยทำให้โครงสร้างมันออกมาดี - ใช้ principle
subtract-before-you-addลบอะไรที่ไม่ได้ใช้ออกไปเลย - ค่อยๆย้ายทีละนิด
- เช็คว่า behavior ยังเหมือนเดิมไหม
- เช็คอีกรอบว่าโค้ดอ่านง่ายขึ้นจริงไหม ถ้าไม่ลบทิ้งทำใหม่
- commit & PR
Perf issue
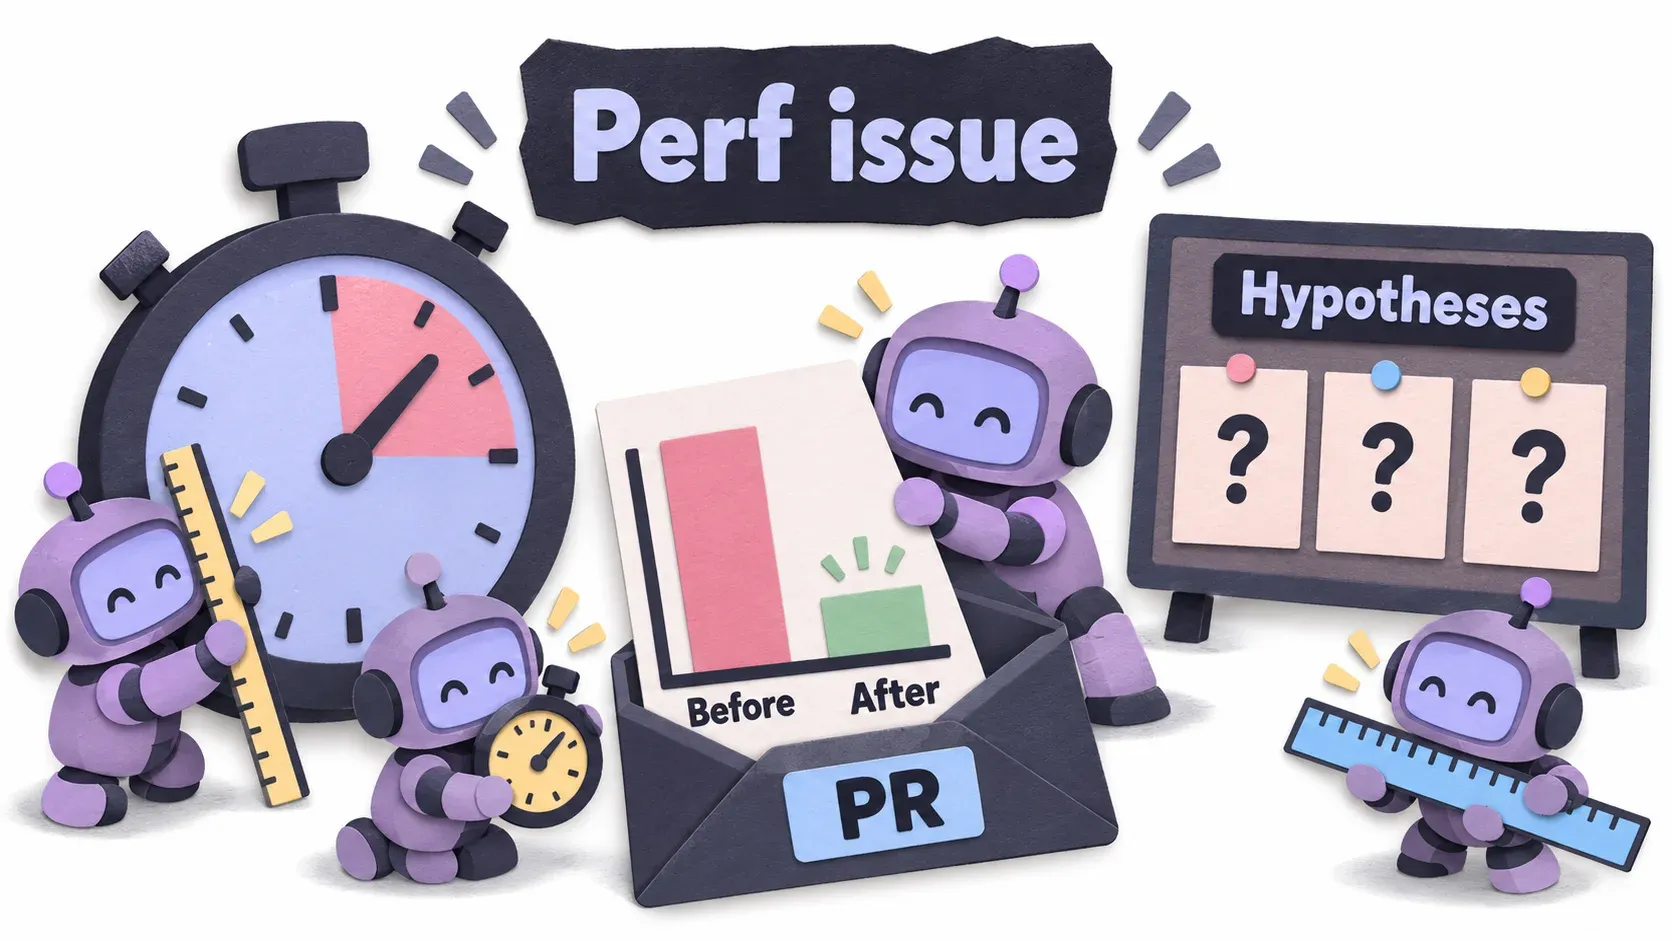
ให้ pstack ช่วยเพิ่ม performance ให้หน่อย ขั้นตอนประมาณนี้
- เก็บข้อมูลก่อน เก็บ trace ตัวเลขต่างๆก่อน ด้วย
/benchmark-checklist - ใช้
/howเพื่อหาว่าช้าตรงไหน แล้วตั้งข้อสังเกต ตั้งสมมติฐานความช้าไว้หลายๆแบบ - วางแผนวัดค่า แล้วให้ subagent ไปวัด
- ใส่ตัวเลขก่อน/หลังใน PR แล้วเปิด PR
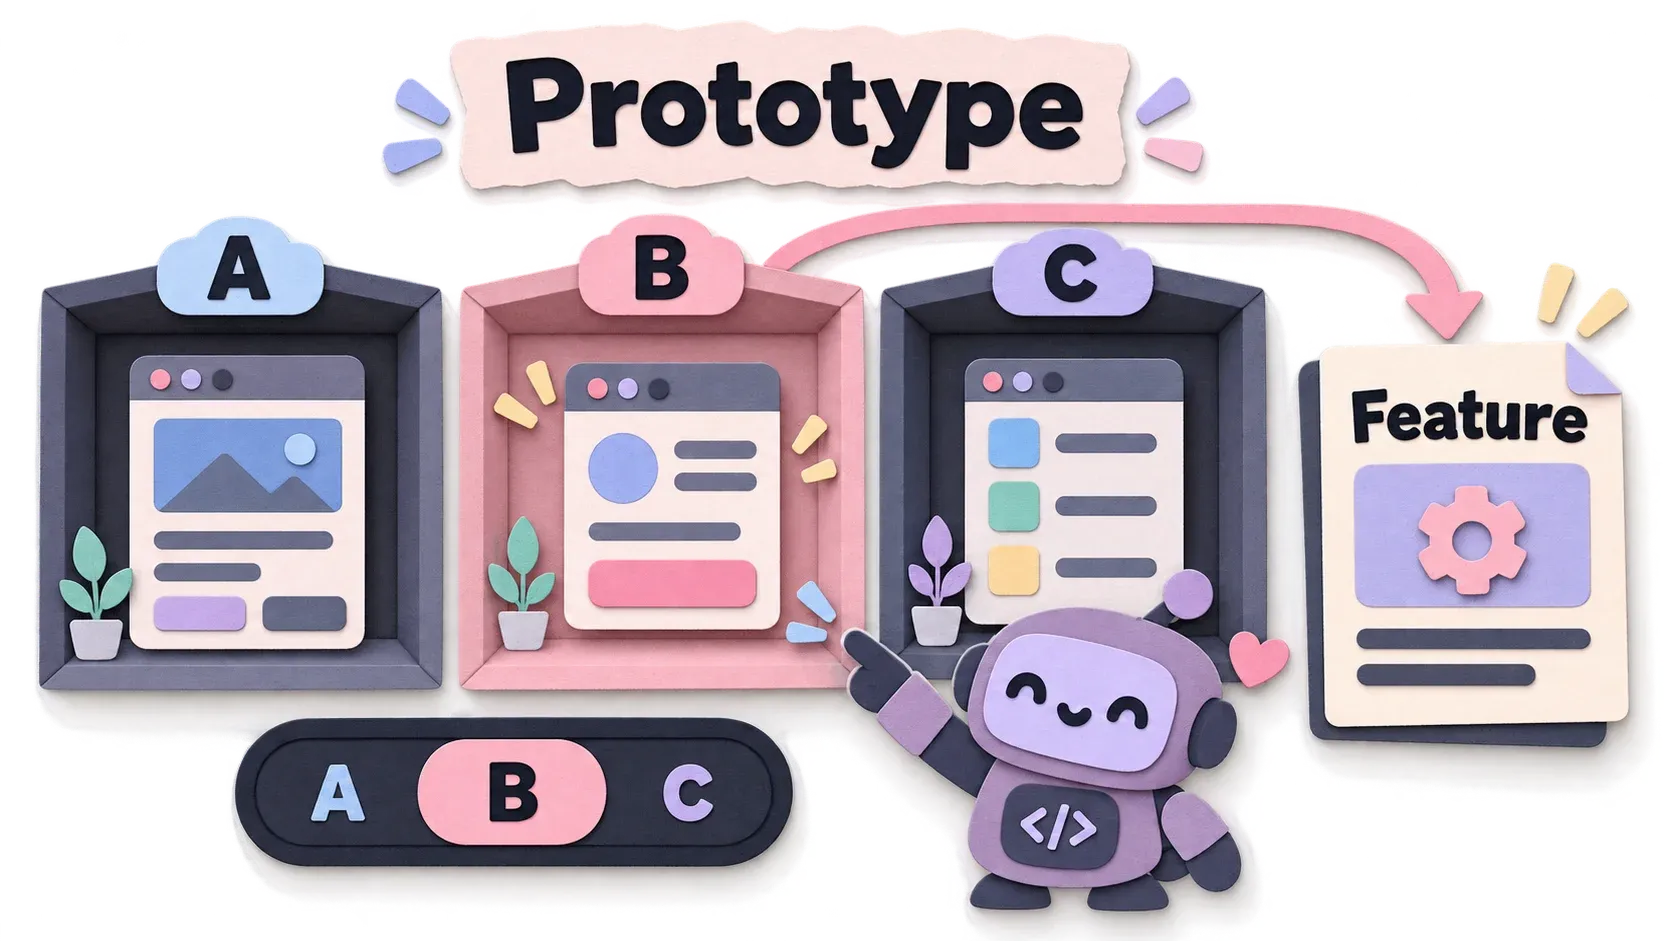
Prototype
ใช้เมื่อเรายังไม่แน่ใจว่าอยากได้อะไรแบบไหน ให้ทำ prototype มาให้เลือกเลย มีขั้นตอนแบบนี้
- ดูก่อนว่าจะทำเรื่องอะไร
- หาตัวอย่างอ้างอิง
- สร้าง prototype ใน folder แยก หรือ worktree แยก
- ถ้าเพิ่มปุ่มสลับไปมาได้ให้ทำเลย เพื่อให้เราเลือกได้ง่ายขึ้น
- ทำ screenshot หรือเปิด server ให้เราเลือกพร้อมคำแนะนำด้วย
- ถ้าเลือกได้แล้วมันจะเปลี่ยนไปใช้ Feature playbook ต่อเลยนะ
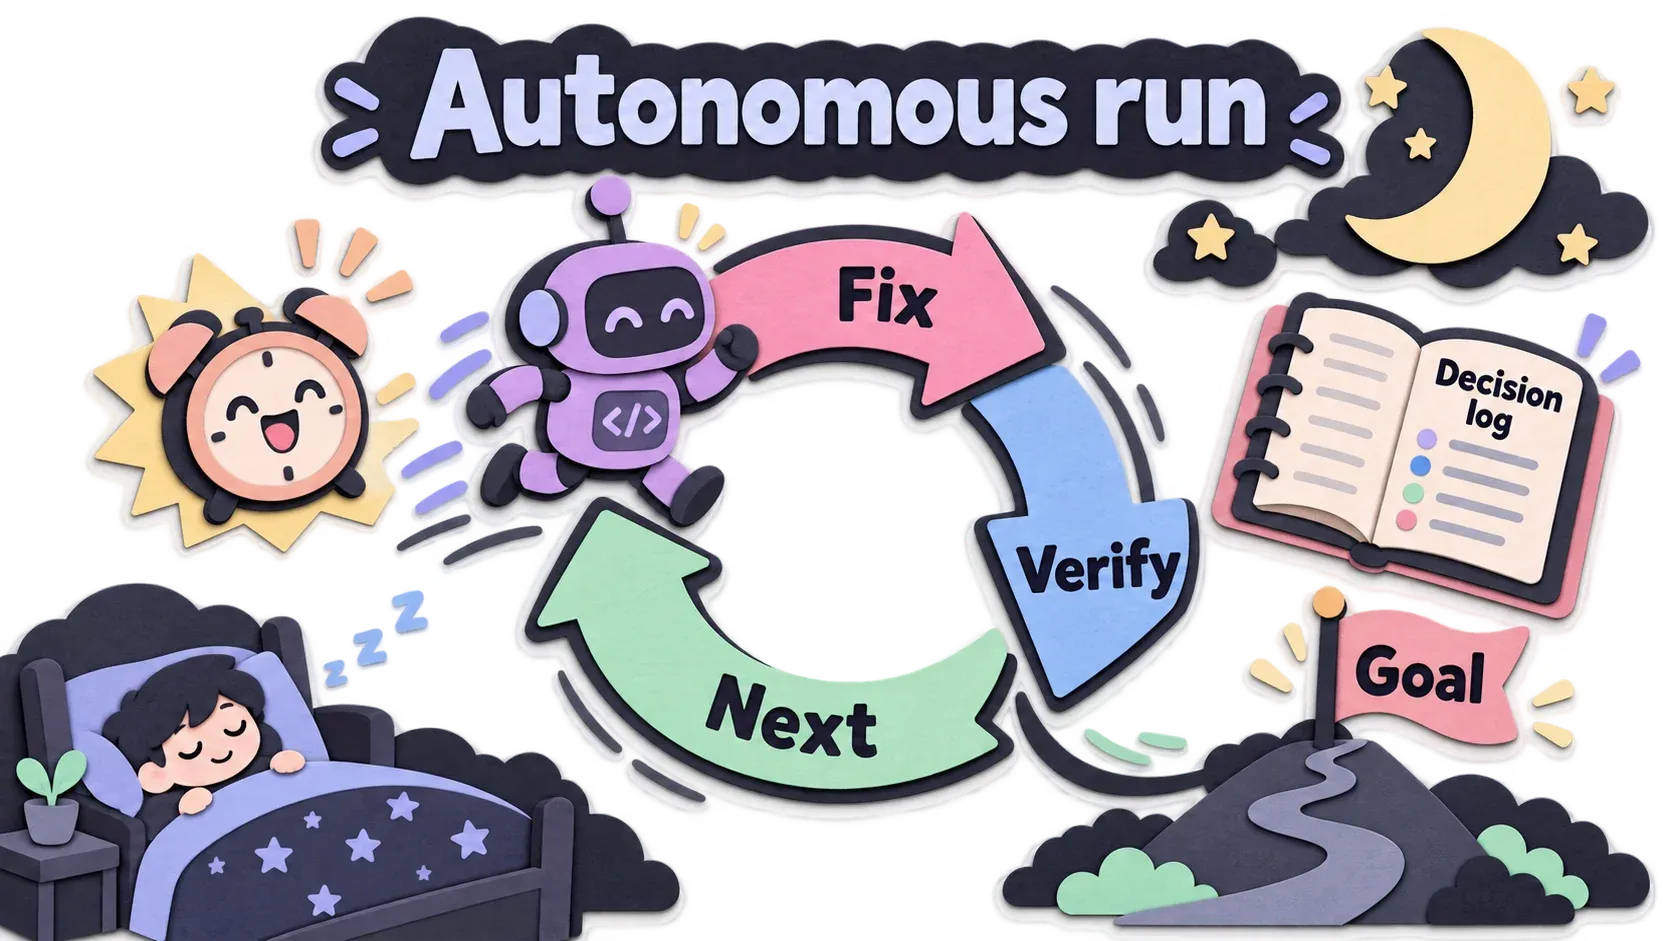
Autonomous run
ใช้ให้ทำงานยาวๆ แต่ต้องมีเป้าหมายชัด คำว่าเสร็จต้องวัดได้ ขั้นตอนประมาณนี้
- ดูก่อนว่าเป้าหมายเป็นอย่างไร
- ตั้งกลไกให้ harness ปลุก agent ขึ้นมาทำงานต่อเอง (ดูกล่องต่างกันตาม harness)
- แต่ละรอบแก้ทีละอย่าง verify แล้วค่อยไปรอบถัดไป
- ถ้าเจอปัญหาให้แก้เองไปเลย ไม่ต้องหยุดถาม ยกเว้นถ้าตรงนั้นย้อนงานกลับไม่ได้
- บันทึก decision log ด้วย
- หยุดเมื่อถึงเป้าที่ตั้งไว้
Opening a PR
ขั้นสุดท้ายของ playbook ส่วนใหญ่ ก่อนเปิด PR มันจะเกลาคำ ลบ comments (/no-comments) และเขียนเอกสารด้วย /technical-writing ให้ดี
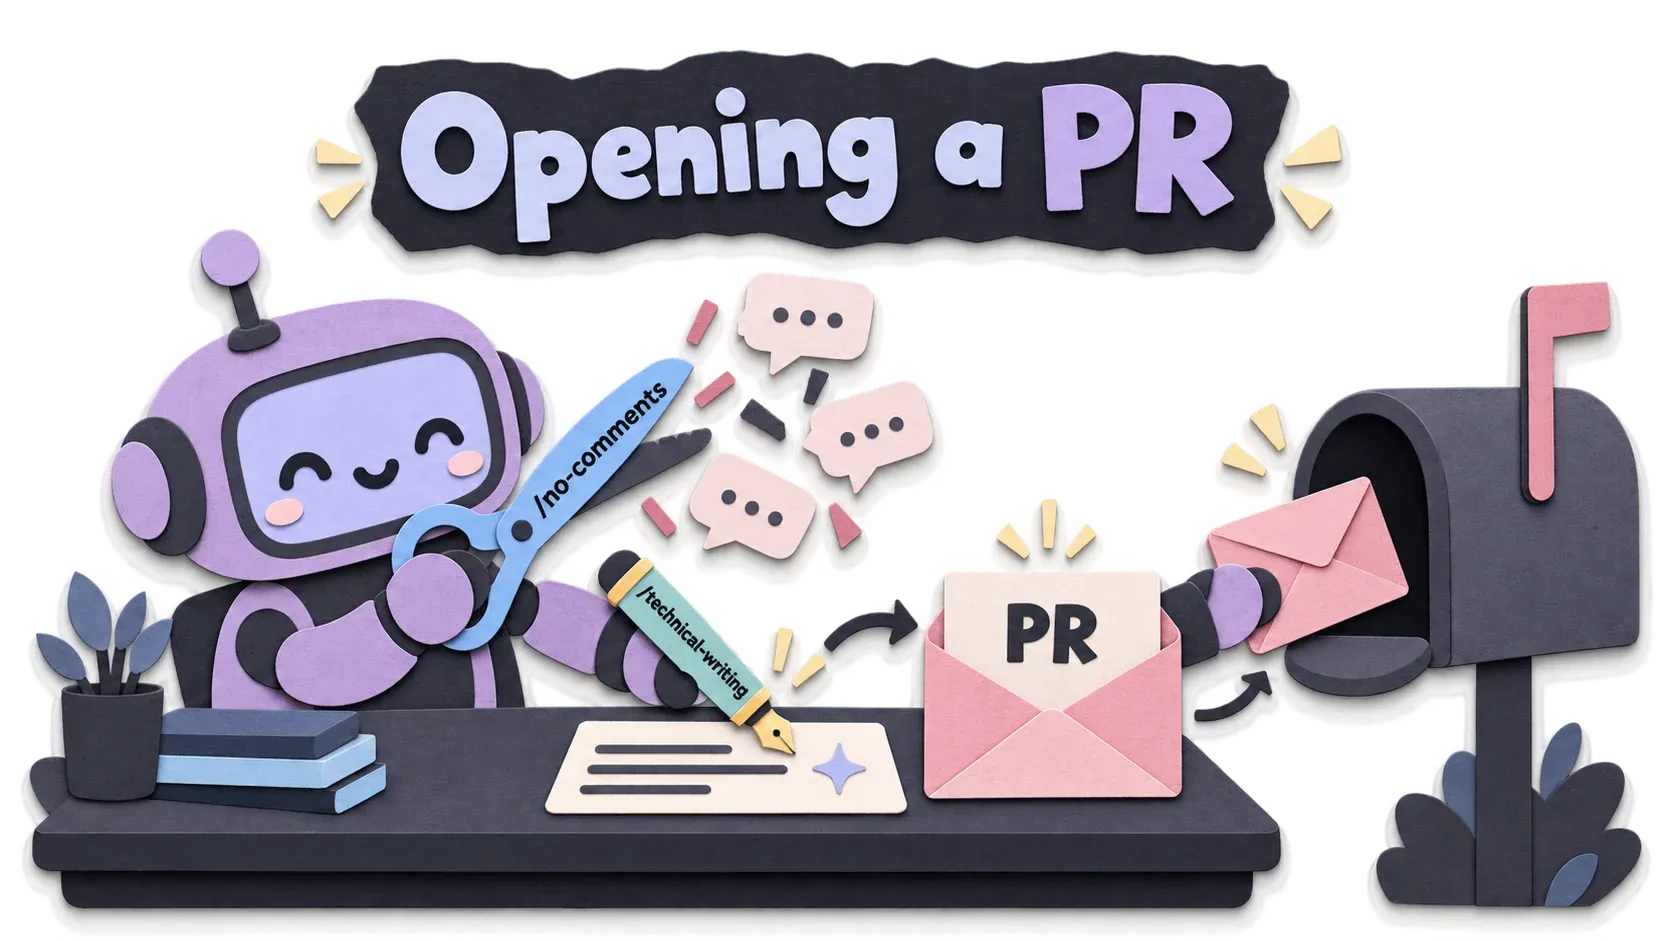
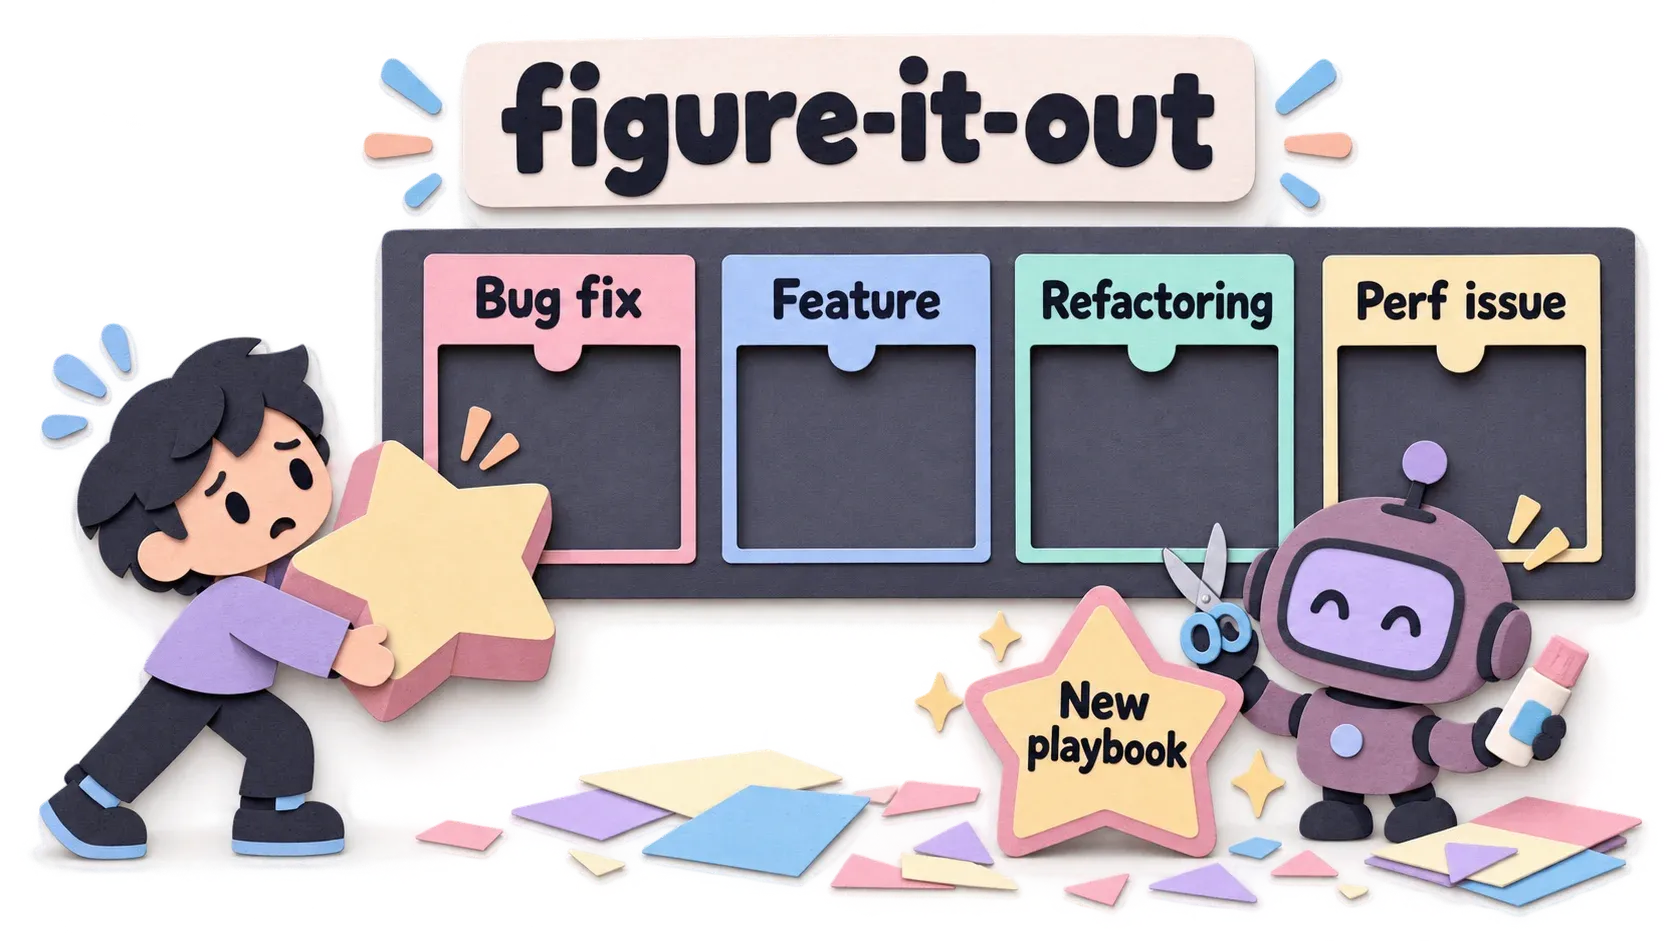
figure-it-out
จริงๆ figure-it-out เป็น skill นะครับ แต่มันค่อนข้างสำคัญและเกี่ยวข้องกับ Playbook ผมเลยเอามาเขียนตรงนี้ด้วย
เวลาเราสั่งงาน เราใช้ /poteto-mode ใช่ไหมครับ
เราก็ prompt ไปปกติ ดีมั่ง ไม่ดีมั่ง ปนๆ วนๆ สั่งไปเลยครับ ไม่ต้องมี keyword อะไรพิเศษ
ถ้า /poteto-mode มันหา playbook ให้เราไม่ได้ มันจะไปเรียก skill figure-it-out นี่แหละ
ทำ playbook เฉพาะทางให้เราเองเลย
playbook ที่ไม่ได้ใช้บ่อย
ผมไม่เขียน steps ละกันนะครับ มันจะยาวมากเลย ผมจะเขียนว่ามันทำอะไรแค่นั้นพอนะ
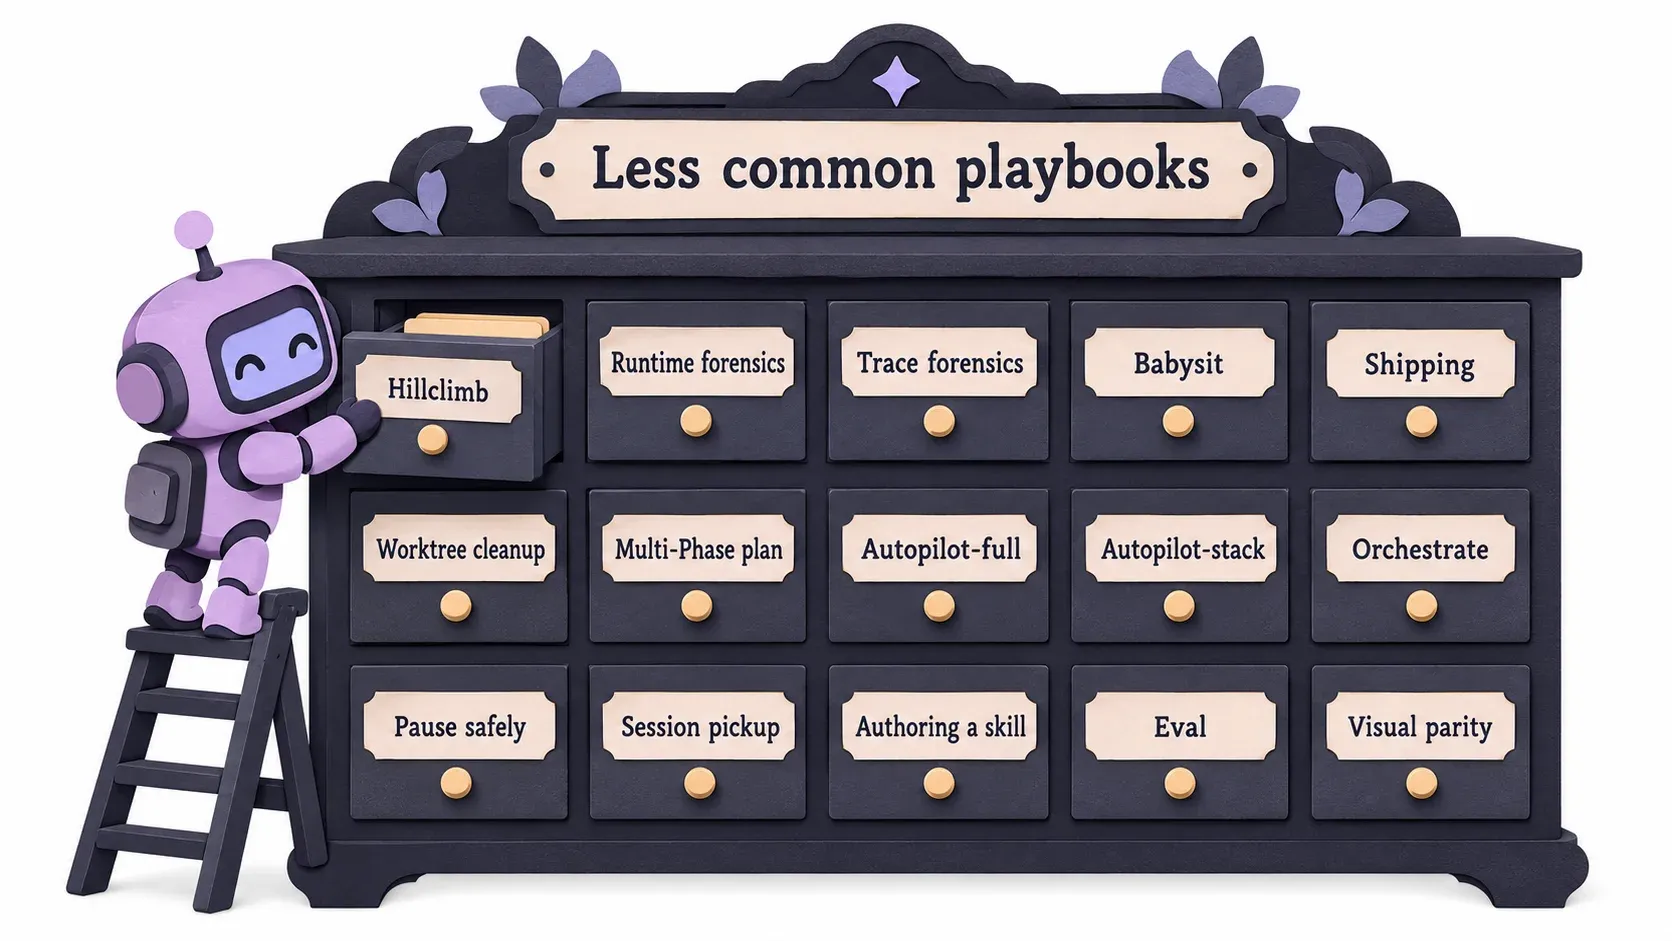
Hillclimb
เอาไว้ใช้ปรับตัวเลข Performance อะไรสักตัวหนึ่งให้ดีขึ้นแบบชัดๆไปเลย แบบว่าค่านี้สำคัญมากๆ ต้องปรับ focus ที่ค่านี้เท่านั้นเลย
Runtime forensics
ใช้ช่วยแก้ปัญหาใน runtime ตัวอย่างเช่น app กิน ram มากเหลือเกิน ไปหาสาเหตุให้หน่อย ถ้าเจอแล้วก็จะส่งต่อ playbook Bug fix หรือ Perf issue ต่อไป
Trace forensics
ใช้ไล่หาสาเหตุจาก trace ที่มีอยู่แล้ว ต่างจาก Perf issue ตรงที่ยังไม่ได้แก้อะไร แค่หาว่าเวลาหายไปไหน เช่น app เปิดช้า มี trace ตอนเปิดอยู่แล้ว ไปอ่านให้หน่อยว่าช้าเพราะอะไร
Babysit
บอกเลข PR แล้วมันจะช่วยดู PR จนกว่าจะผ่าน จนกว่าจะพร้อม merge อะ
Shipping
ใช้ช่วย merge PR หลายๆอัน ที่มันอาจจะมีหลายๆ PR ให้เข้า main ได้อย่างปลอดภัย ก็มักจะใช้หลังจาก Babysit อะ
worktree cleanup
ตามชื่อช่วยลบ worktree ที่ไม่ใช้แล้วให้หน่อย
Multi-Phase plan
ถ้างานใหญ่มากๆก็จะแบ่งเป็นแผนงานเล็กๆหลายๆงาน แต่ว่าแต่ละงานต้องมีวิธี verify ที่แยกจากกันได้ชัดเจนด้วยนะ
Autopilot-full
เรามีงานหลายๆงาน แต่ทุกงานไม่ได้เกี่ยวข้องกันเลย ให้มันไปทำงาน แล้วให้ merge ให้ด้วยเลย
Autopilot-stack
เหมือน autopilot full เลย แต่ว่าไม่ต้อง merge นะ เตรียม PR ไว้ก็พอ
Orchestrate
playbook นี้ต้องรวยหน่อย
ใช้กับงานใหญ่มากๆ เช่นเริ่มต้นระบบใหม่ที่มี scope ใหญ่มาก แต่ค่อนข้างชัดหมดแล้วทุกจุด คือพร้อมทำงาน ถ้า token เหลือ Disk/MEM มีเยอะ ก็จัดไปครับ
session หลักจะทำตัวเป็น coordinator ครับ แล้วเปิด subagent 10-100 ตัวมาทำงาน
Pause safely
คือบอกให้หยุดงานก่อน
เราอาจจะเอา token ไปทำอย่างอื่นก่อน อะไรแบบนั้น หรือต้องปิดเครื่อง หรือ net จะหมด ก็ได้ทั้งนั้น
Session pickup
เราอาจจะมีงานค้างอยู่ playbook นี้จะไปหามาให้ว่างานล่าสุดที่ค้างอยู่คืออะไร ก็ทำต่อจากการ pause playbook อะ
Authoring a skill
ใช้ช่วยเราเขียน skill ครับ
Eval
อันนี้ต่อเนื่องจาก playbook Authoring a skill คือเราต้องตรวจด้วยว่า skill ที่สร้างทำได้ได้ถูกต้องหรือเปล่า ก็ใช้ playbook Eval ครับ
Visual parity
พึ่งมาใหม่เลย มันทำอะไรหว่า
สร้าง mode ของตัวเองกัน
แนะนำให้ใช้ /automate-me ช่วยทำนะ
ทำเป็น mode ใหม่เลยเท่ดี เช่น /my-mode ซึ่งจริงๆมันก็เป็น skill ธรรมดานี่แหละ ด้านใน SKILL.md
มีหัวข้อ ## Playbooks เลียนแบบ /poteto-mode ก็เท่านั้น
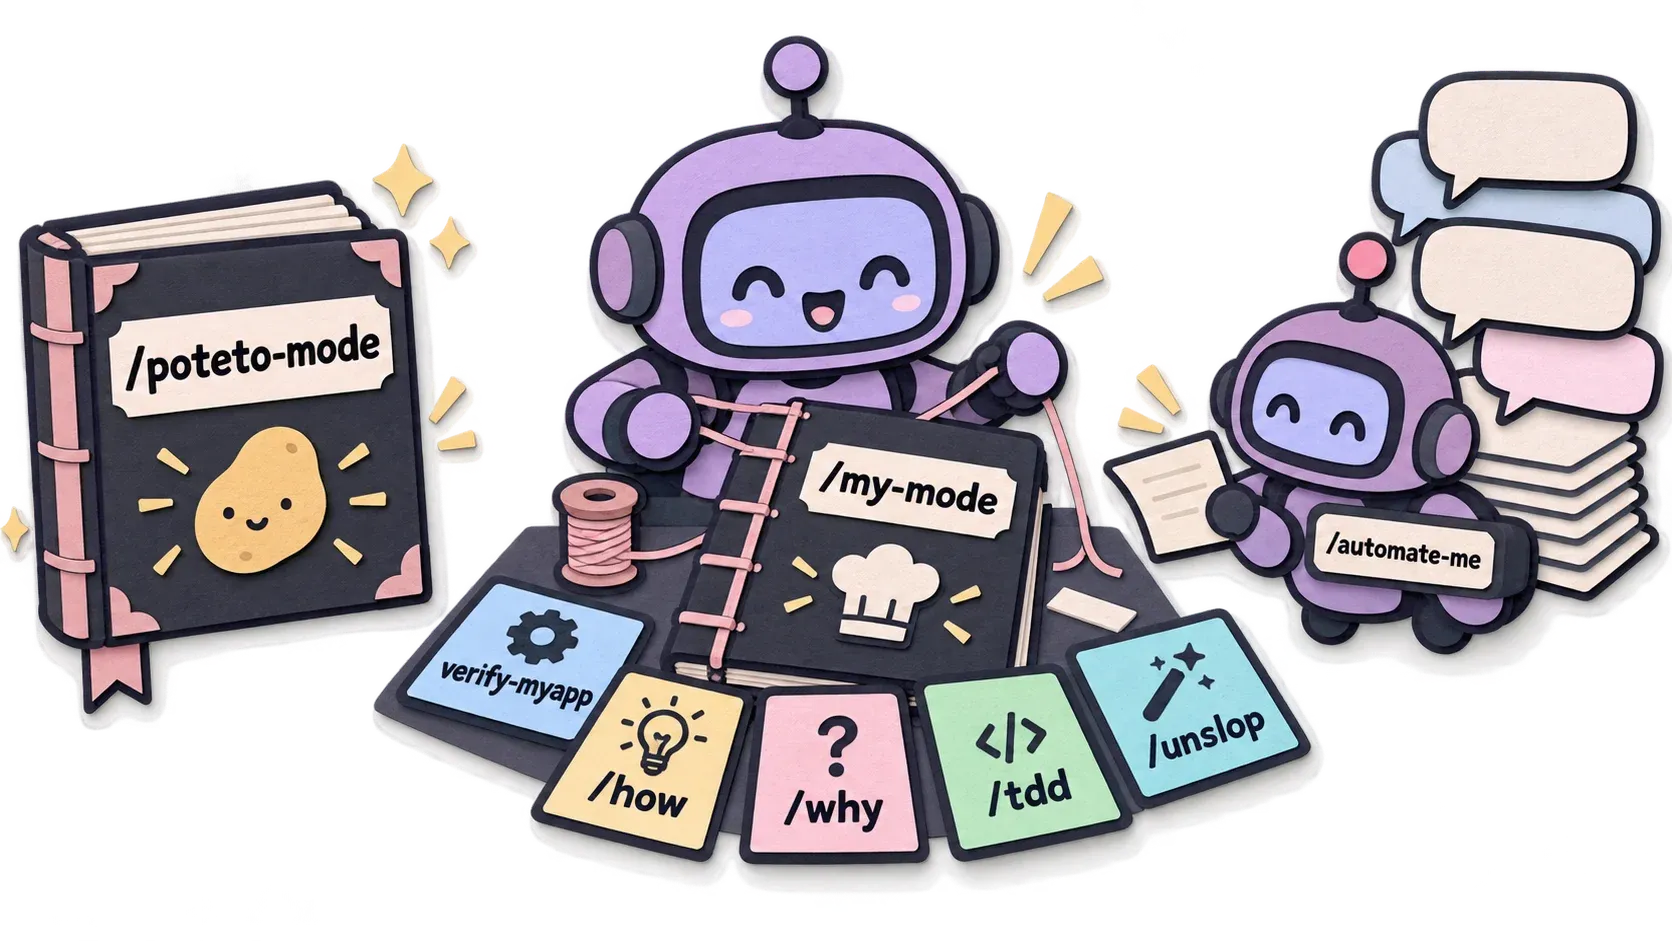
skills ของ pstack ตั้ง disable-model-invocation: true ไว้ แปลว่า agent จะไม่หยิบมาใช้เอง ต้องมีใครอ้างชื่อตรงๆ ทำให้ playbook ของเราจึงต้องเขียนชื่อ skill ให้ชัด ตัวอย่างเช่น
---name: my-modedescription: ใช้เมื่อเริ่มงานใหม่ใน repo นี้disable-model-invocation: true---## Playbooks### Bug fix (ของทีมเรา)1. Reproduce ด้วย skill://verify-myapp ให้ได้ก่อน ถ้าไม่ได้ stop the line2. อ่าน skill://how กับ skill://why แล้วตั้งสมมติฐาน3. เขียน test ที่ fail ด้วย skill://tdd แล้วค่อยแก้4. Verify ซ้ำด้วย skill://verify-myapp แนบ screenshot5. รัน skill://no-comments และ skill://unslop ก่อน commitถ้างบน้อย เริ่มจากอะไรดี
- ยังไงก็ต้องเริ่มที่ Verification skill ก่อน ส่วนนี้ประหยัด token ระยะยาวเลยละ
- ใช้ model เดียวไปก่อน ข้าม panel,
/arena,/interrogateแบบหลาย model - ใช้ playbook Bug fix กับ Investigation ให้คล่องก่อน
- เปิด
/reflectหลังจบงานใหญ่ เพื่อดูว่าจุดไหนควรปรับ
ความเห็นของผม
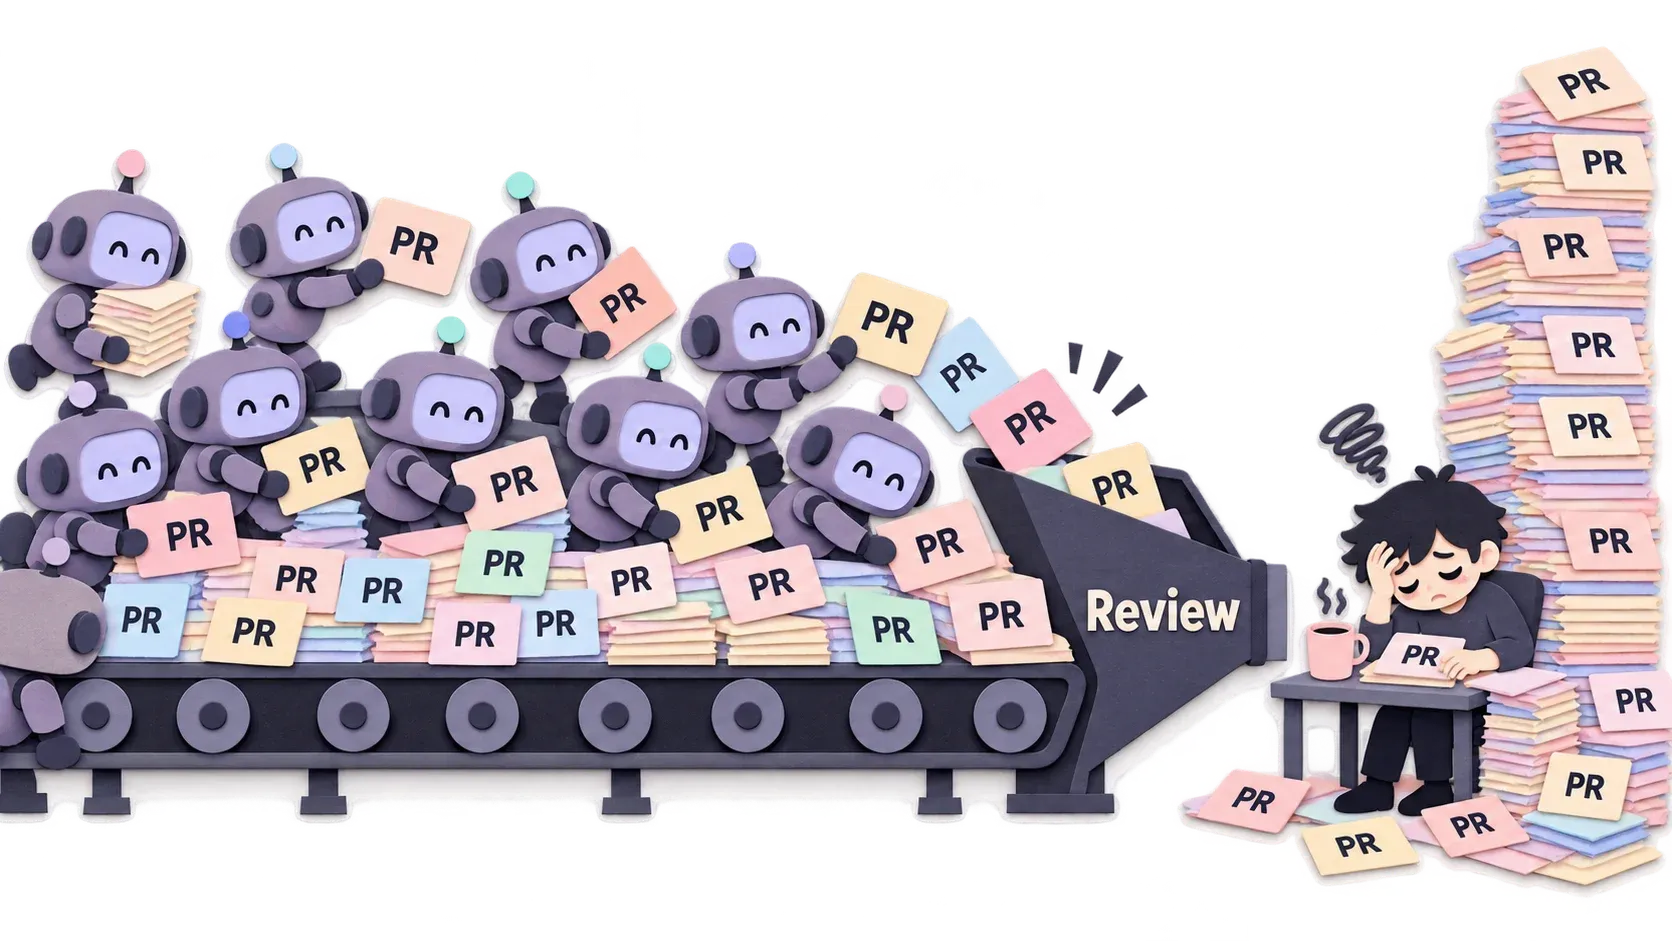
- คอขวดย้ายไปที่คนรีวิว ส่ง PR ได้เป็นพัน แต่คนรีวิวยังมีเท่าเดิม สำหรับผมคิดว่าการจัด PR Tier ก็น่าสนใจนะ จัด Tier ก่อนว่า PR ไหนสำคัญระดับไหน ถ้ากลางๆถึงน้อยอาจจะให้ AI ช่วย review ถ้าสูงก็ทำเอง
- Verification skill ต้องดูแลตลอด ถ้าไม่ maintain มันจะตรวจของที่ไม่มีอยู่แล้ว
- agent ตรวจงานตัวเองก็เข้าข้างตัวเองได้ นี่คือเหตุผลที่ pstack ใช้ panel หลาย model ไง
- เปลือง คือมันใช้หลาย model หลายค่ายอะ มันเปลืองกว่า workflow ของพี่ Matt ในหลายๆเคสที่ผมลอง แต่ภาพรวมดีมากนะ
สรุป
ตอนต้นผมถามว่า project เราพร้อมสำหรับ pstack หรือยัง คำตอบอยู่ที่ Verification skill ครับ
- สร้าง Verification skill ก่อนใช้
/poteto-mode - สั่ง
/poteto-modeด้วยอาการกับสิ่งที่อยากได้ ไม่ต้องบอกขั้นตอน - ใช้
/maintain-verification-skillเป็นประจำ - ใช้ไปสักพัก เราจะเจอว่า pstack Playbook ก็ไม่ได้เหมาะกับเราเท่าไร ตรงนี้แหละค่อยปรับเป็น
/my-modeของตัวเอง
ส่วนตัวผมใช้ skill ของพี่ Matt คู่กับ pstack นะครับ
ให้เริ่มที่ /grill-with-doc -> /to-spec -> /poteto-mode ครับ
บางครั้งถ้าสิ่งที่จะทำมันเล็กๆ ผมไม่ใช้ pstack เลย เพราะมันเปลือง token พอสมควร ดูไม่คุ้มครับ
เรื่องนี้ถ้าเพื่อนๆลองใช้งานเดี๋ยวก็จะจับทางได้ว่าตรงไหนควรใช้ไม่ควรใช้ครับ
flow ทั้งหมดที่ควรใช้
ผมรวบให้เป็น flow เดียวนะครับ เผื่อใครอ่านมาถึงตรงนี้แล้วลืมของข้างบนไปแล้ว ฮ่าๆ
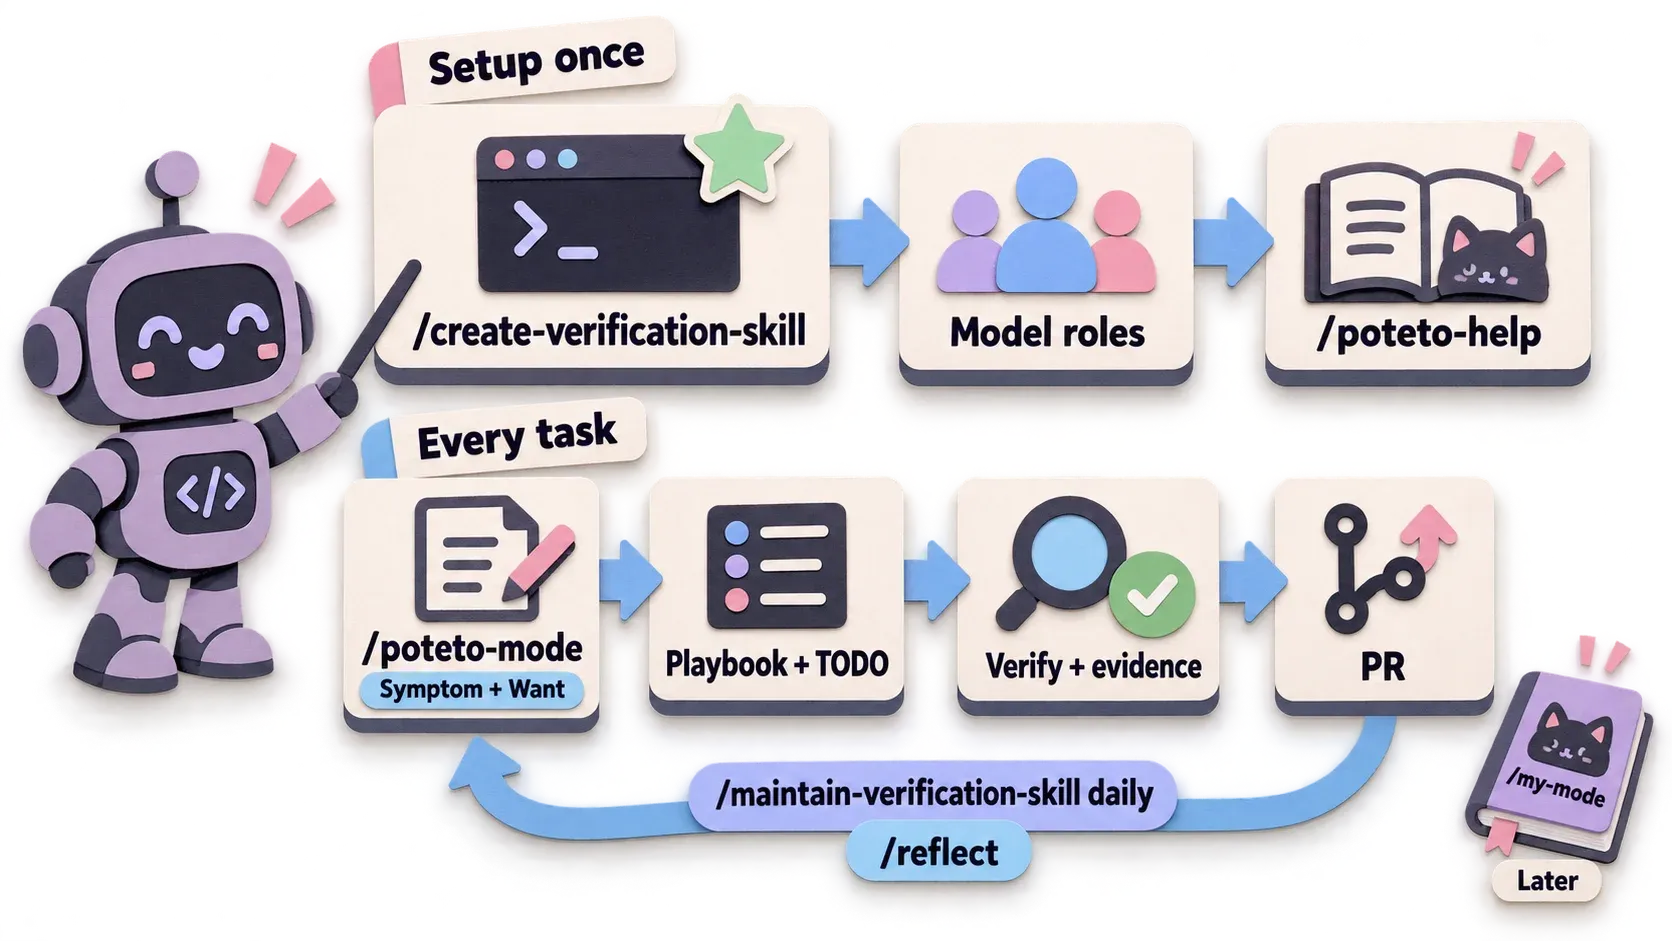
ครั้งแรก ทำครั้งเดียว
- ติดตั้ง pstack ตาม harness ที่เราใช้ Cursor ก็
/add-plugin pstackส่วน harness อื่นก็ใช้ตัวที่มีคน port มา - ใช้
/create-verification-skillให้ได้ SKILL.md, CLI และ Feature map ของ repo เรา แล้วไล่ checklist 5 ข้อในหัวข้อ Setup ดูว่าตอบ “มี” ได้ครบหรือยัง - ตั้ง model roles ถ้างบน้อยก็ใช้ model เดียวไปก่อน
- ตรงไหนไม่แน่ใจ ถาม
/poteto-helpได้เลย
ทุกครั้งที่มีงาน
- ขึ้น session ใหม่ แล้วสั่ง
/poteto-modeด้วยอาการกับสิ่งที่อยากได้ ไม่ต้องบอกขั้นตอน ไม่ต้องบอกสมมติฐาน - ปล่อยให้มันเลือก playbook เอง ถ้าไม่มีตัวไหนเหมาะ มันจะเรียก
figure-it-outทำ playbook ให้ - เหลือบดู TODO list หน่อยว่า copy ขั้นตอนจาก playbook มาครบไหม ข้อที่ข้ามมี
skip:หรือn/a:พร้อมเหตุผลหรือเปล่า - ก่อนเชื่อว่าเสร็จ ต้องมีหลักฐานจาก Verification skill เช่น screenshot, log, output ถ้าไม่มี ก็ยังไม่เสร็จนะครับ
- ปิดงานด้วย Opening a PR
- ตามงานไม่ทัน ใช้
/ketchupหรือ/show-me-your-workอ่านแล้วยังงงก็ต่อด้วย/bro
ดูแลเป็นประจำ
/maintain-verification-skillทุกวัน ไม่งั้นมันจะตรวจของที่ไม่มีอยู่แล้ว/reflectหลังจบงานใหญ่ ดูว่าครั้งหน้าควรปรับอะไร- ถ้าต้องสั่งเรื่องเดิมเกิน 2 รอบ ใช้
/correctให้มันหาทางบังคับด้วย type, lint หรือ script แทน
ระยะยาว
- ใช้ไปสักพักจนรู้ว่าส่วนไหนเหมาะกับ project เรา ส่วนไหนไม่เหมาะ แล้วค่อยใช้
/automate-meช่วยทำ/my-modeของเราเอง
สุดท้ายนี้ ถ้าจำได้อย่างเดียวจากบทความนี้ ขอให้จำว่า pstack จะดีได้ก็ต่อเมื่อ agent ตรวจงานตัวเองได้จริงครับ เริ่มจาก Verification skill ก่อนเสมอ
ส่วนท้ายที่แถมให้ ไม่ต้องอ่านก็ได้
ตาราง Roles ทั้ง 17 ตัว
| # | Role | ทำงานอะไร | ค่าเริ่มต้น (ต.ค. 2026) |
|---|---|---|---|
| 1 | feature, refactoring | subagent ที่เขียนโค้ดใน playbook Feature และ Refactoring | Grok 4.7 xhigh-fast |
| 2 | bug-fix | subagent ที่เขียน fix ใน playbook Bug fix | Grok 4.7 xhigh-fast |
| 3 | perf-issue | subagent ที่แก้ความช้าใน playbook Perf issue | Grok 4.7 xhigh-fast |
| 4 | hillclimb | subagent ที่ลองแก้ทีละสมมติฐาน ใน playbook Hillclimb | Grok 4.7 xhigh-fast |
| 5 | judgment and prose | ตัดสินใจ เขียนแผน เขียน PR และงานเขียนทั้งหมด | Claude Opus 5.5 xhigh |
| 6 | hardest tasks | งานที่ยากที่สุด ซึ่ง model เร็วน่าจะพลาด | Claude Opus 5.5 xhigh |
| 7 | how explorer | /how: ตัวเดินไล่อ่านโค้ด | Grok 4.7 xhigh-fast |
| 8 | how explainer | /how: ตัวเรียบเรียงคำอธิบายให้คนอ่าน | Claude Opus 5.5 xhigh |
| 9 | why investigators | /why: ตัวขุด git history, PR, issue | Grok 4.7 xhigh-fast |
| 10 | why synthesizer | /why: ตัวสรุปจากหลักฐานว่าทำไม | Claude Opus 5.5 xhigh |
| 11 | reflect tooling | /reflect: งานใช้เครื่องมือ เช่น อ่านแชท ค้นไฟล์ | Grok 4.7 xhigh-fast |
| 12 | reflect judgment, divergent, synthesizer | /reflect: reviewer 2 มุม (ตัดสิน, มองต่าง) กับตัวสรุปข้อเสนอ | Claude Opus 5.5 xhigh |
| 13 | arena runners | candidate ใน /arena 1 ตัวต่อ 1 รายการ | 2 ตัว: Opus + Grok |
| 14 | arena cross-judge pool | รายชื่อให้เลือก judge 1 ตัว (ไม่ใช่ panel) | Opus, Grok: เลือกตัวที่ต่างตระกูลจากแชทหลักก่อน |
| 15 | architect runners | candidate ตอน /architect ส่งงานให้ arena | 2 ตัว: Opus + Grok |
| 16 | swarm workers | worker ใน /swarm | Grok 4.7 xhigh-fast |
| 17 | interrogate reviewers | reviewer ใน /interrogate 1 ตัวต่อ 1 รายการ | 2 ตัว: Opus + Grok |
ศัพท์ยากโครตๆ ผมเพิ่มเติมให้เผื่อว่าใครไปอ่าน repo จริง
- sweep = ไล่ตรวจทุก feature ตั้งแต่ต้นจนครบ มักใช้ก่อนปล่อย version ใหม่
- Fuzz = ให้ AI ป้อนข้อความแปลกๆ ทำอะไรแปลกๆ เพื่อหา bug
- Escape hatch = ทางหนี ถ้า agent ทำต่อเองไม่ได้จริงๆ มันจะหยุดแล้วบอกเหตุผล เจอในตัว skill แต่ปกติเราไม่ได้ใช้เอง